自动识别硬件
显卡、处理器、内存、磁盘一次看清,直接告诉你哪些模型能跑、能跑多快。
本地大模型 · 一键部署v0.1.0
LocModel 自动看懂你的硬件,推荐合适的开源模型,装好推理引擎。在线下载或导入 GGUF,点一下,就在本地跑起来。
Windows 10/11 · x64·NVIDIA / AMD / Intel / CPU·数据留在本地
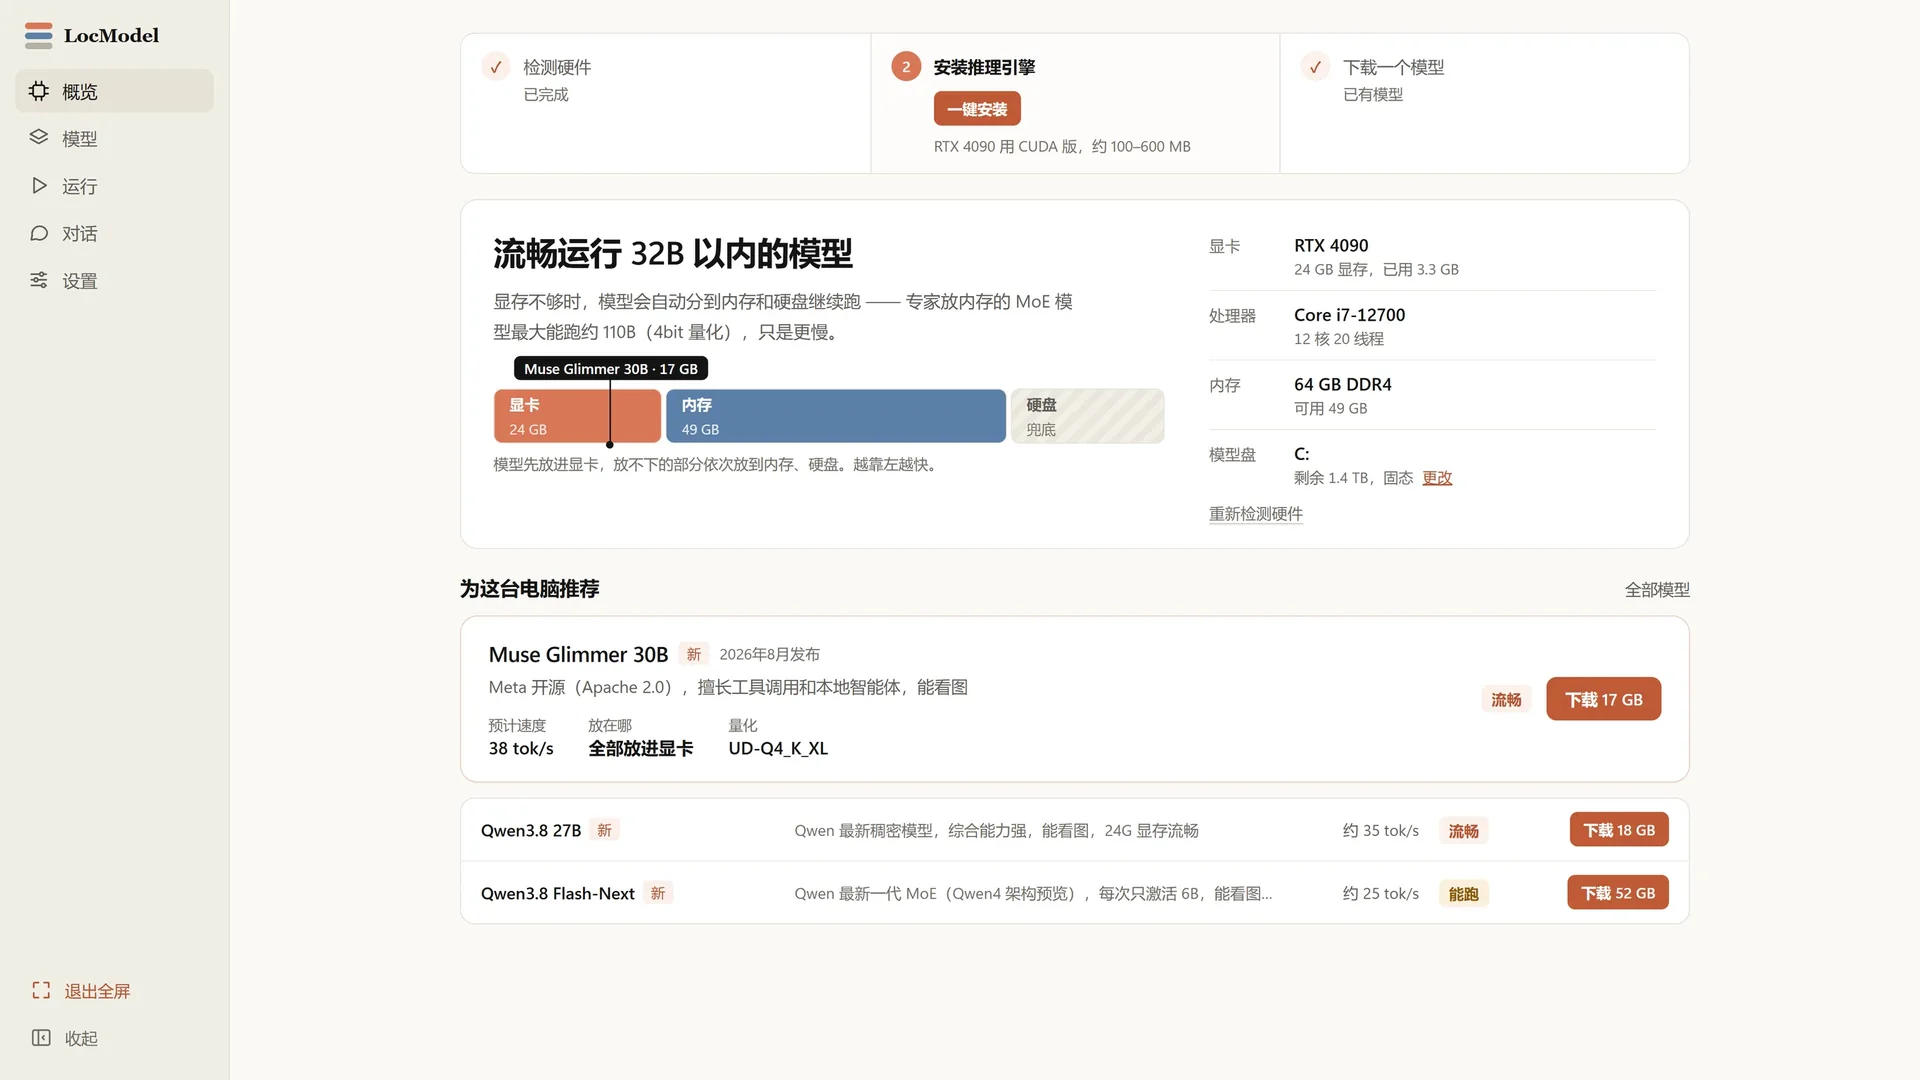
01LocModel 0.1.0 · 概览
WHY LOCMODEL
不用配环境,不用记参数。LocModel 把最麻烦的部分收起来,把模型留给你。
显卡、处理器、内存、磁盘一次看清,直接告诉你哪些模型能跑、能跑多快。
自动匹配 llama.cpp 后端,NVIDIA、AMD、Intel 和纯 CPU 都照顾到,不用自己编译。
在线下载 HuggingFace 模型,也能导入本地 GGUF。模型是你的,不锁在某个平台里。
显存放不下时,自动把部分层放进内存和硬盘。大模型照样能跑,只是慢一点。
01 / HARDWARE
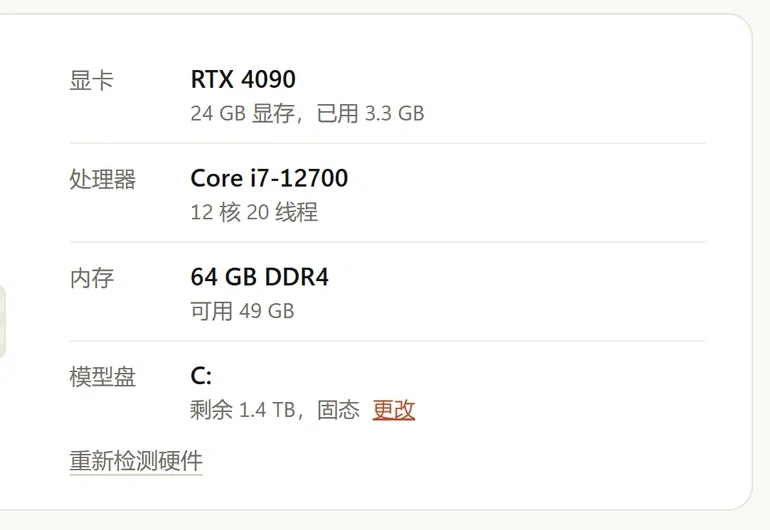
打开 LocModel,先看到的不是参数,而是一份硬件体检:显卡型号与显存、处理器核心、可用内存、模型盘空间。
02 / ENGINE
LocModel 会自动下载与你的显卡匹配的 llama.cpp 官方构建。网络不好,也可以手动导入 zip,进度、速度、剩余时间都看得见。
03 / MODELS
推荐模型、在线搜索、已安装管理放在同一页。每个模型都标好大小、量化方式、预计速度和适配程度。
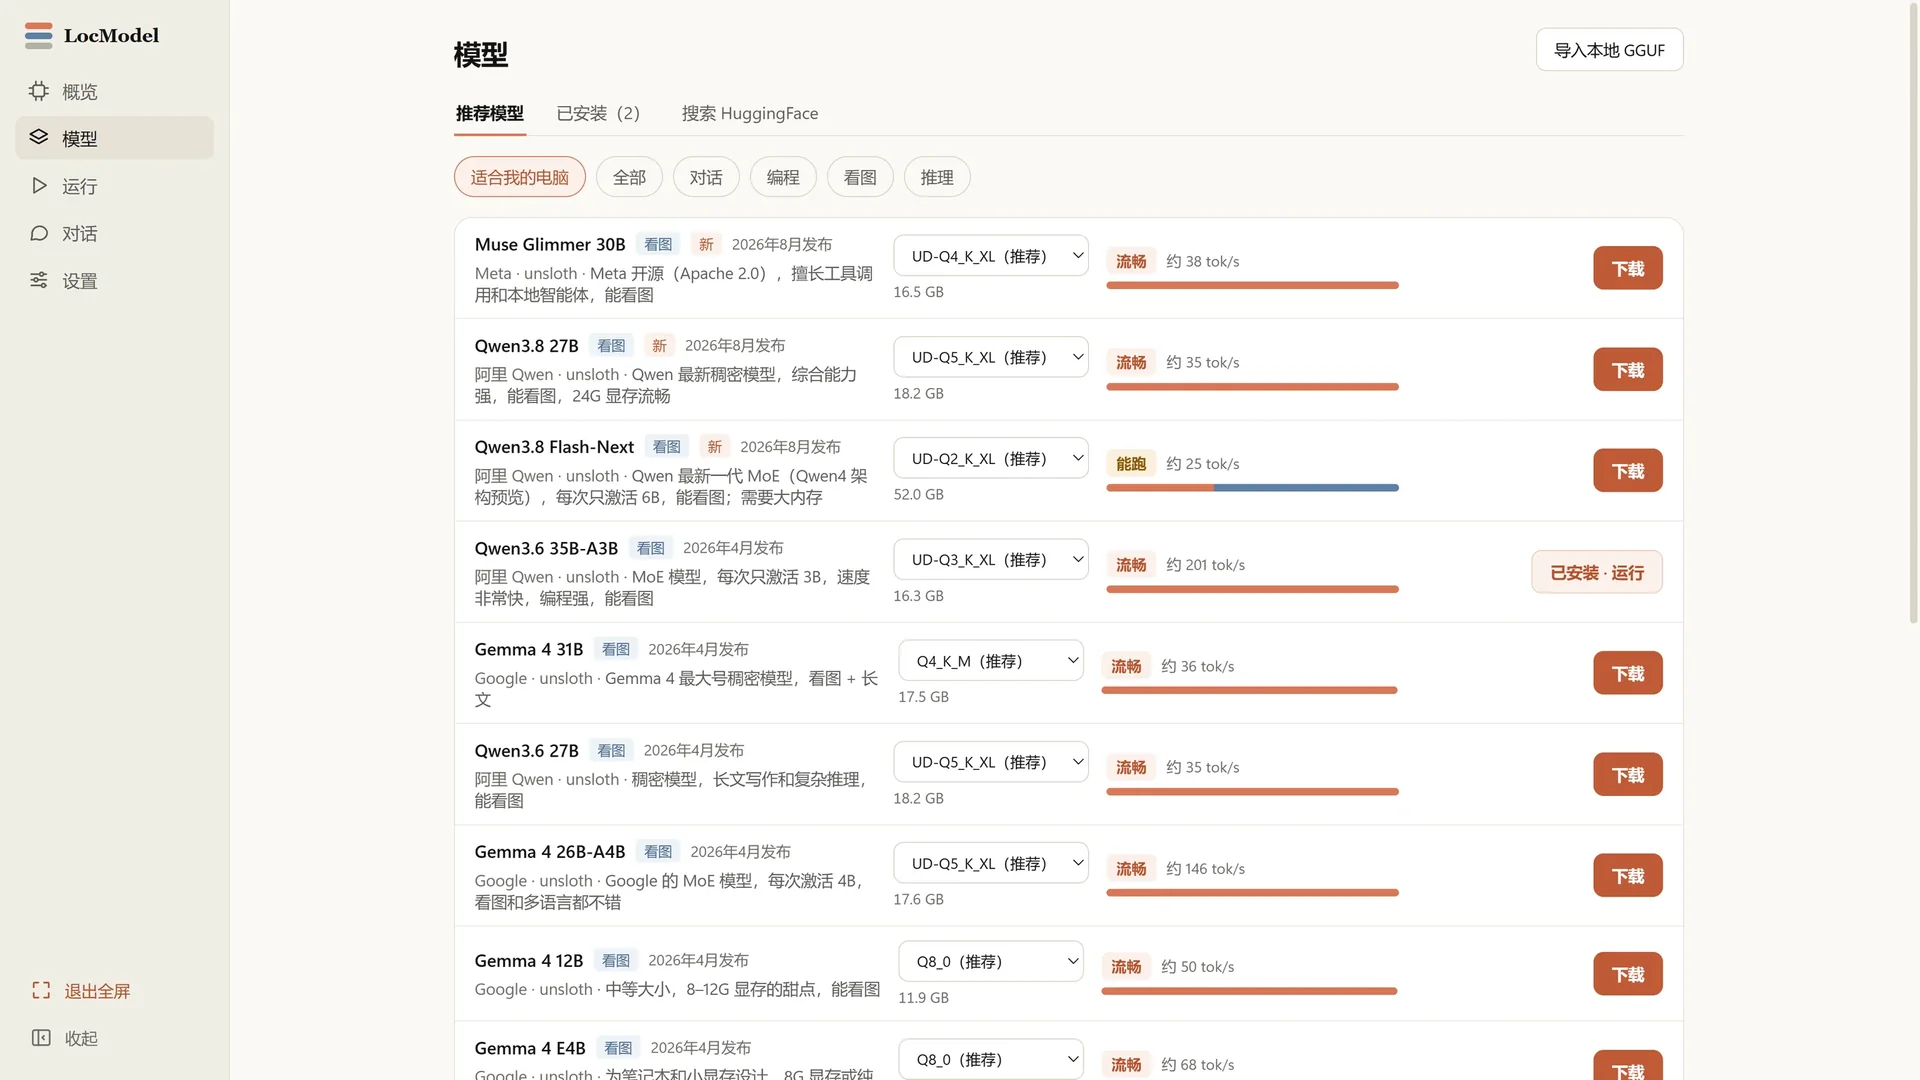
按硬件与用途筛选 HuggingFace 模型,点一下就开始下载。
本地文件直接导入,不用转换格式,也不用上传到任何地方。
版本、大小、量化方式与运行状态,一页看完。
04 / RUN
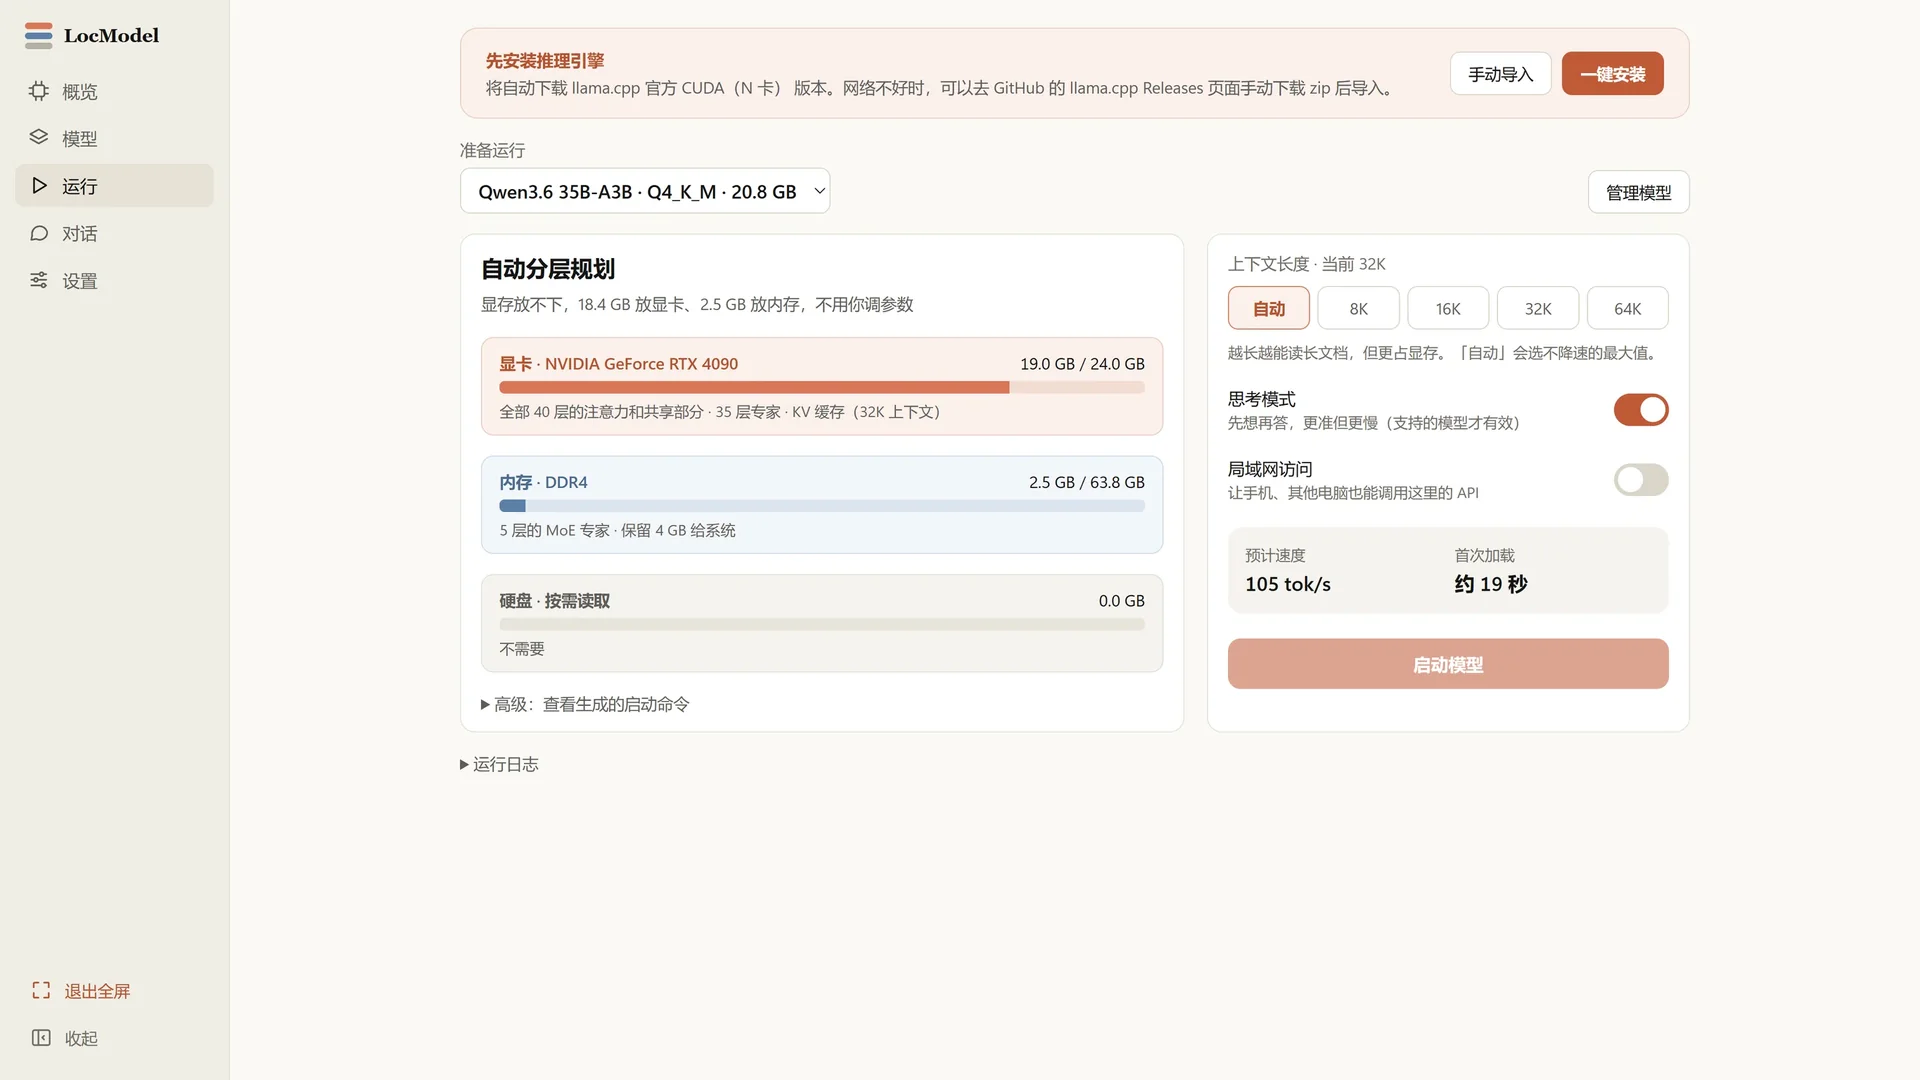
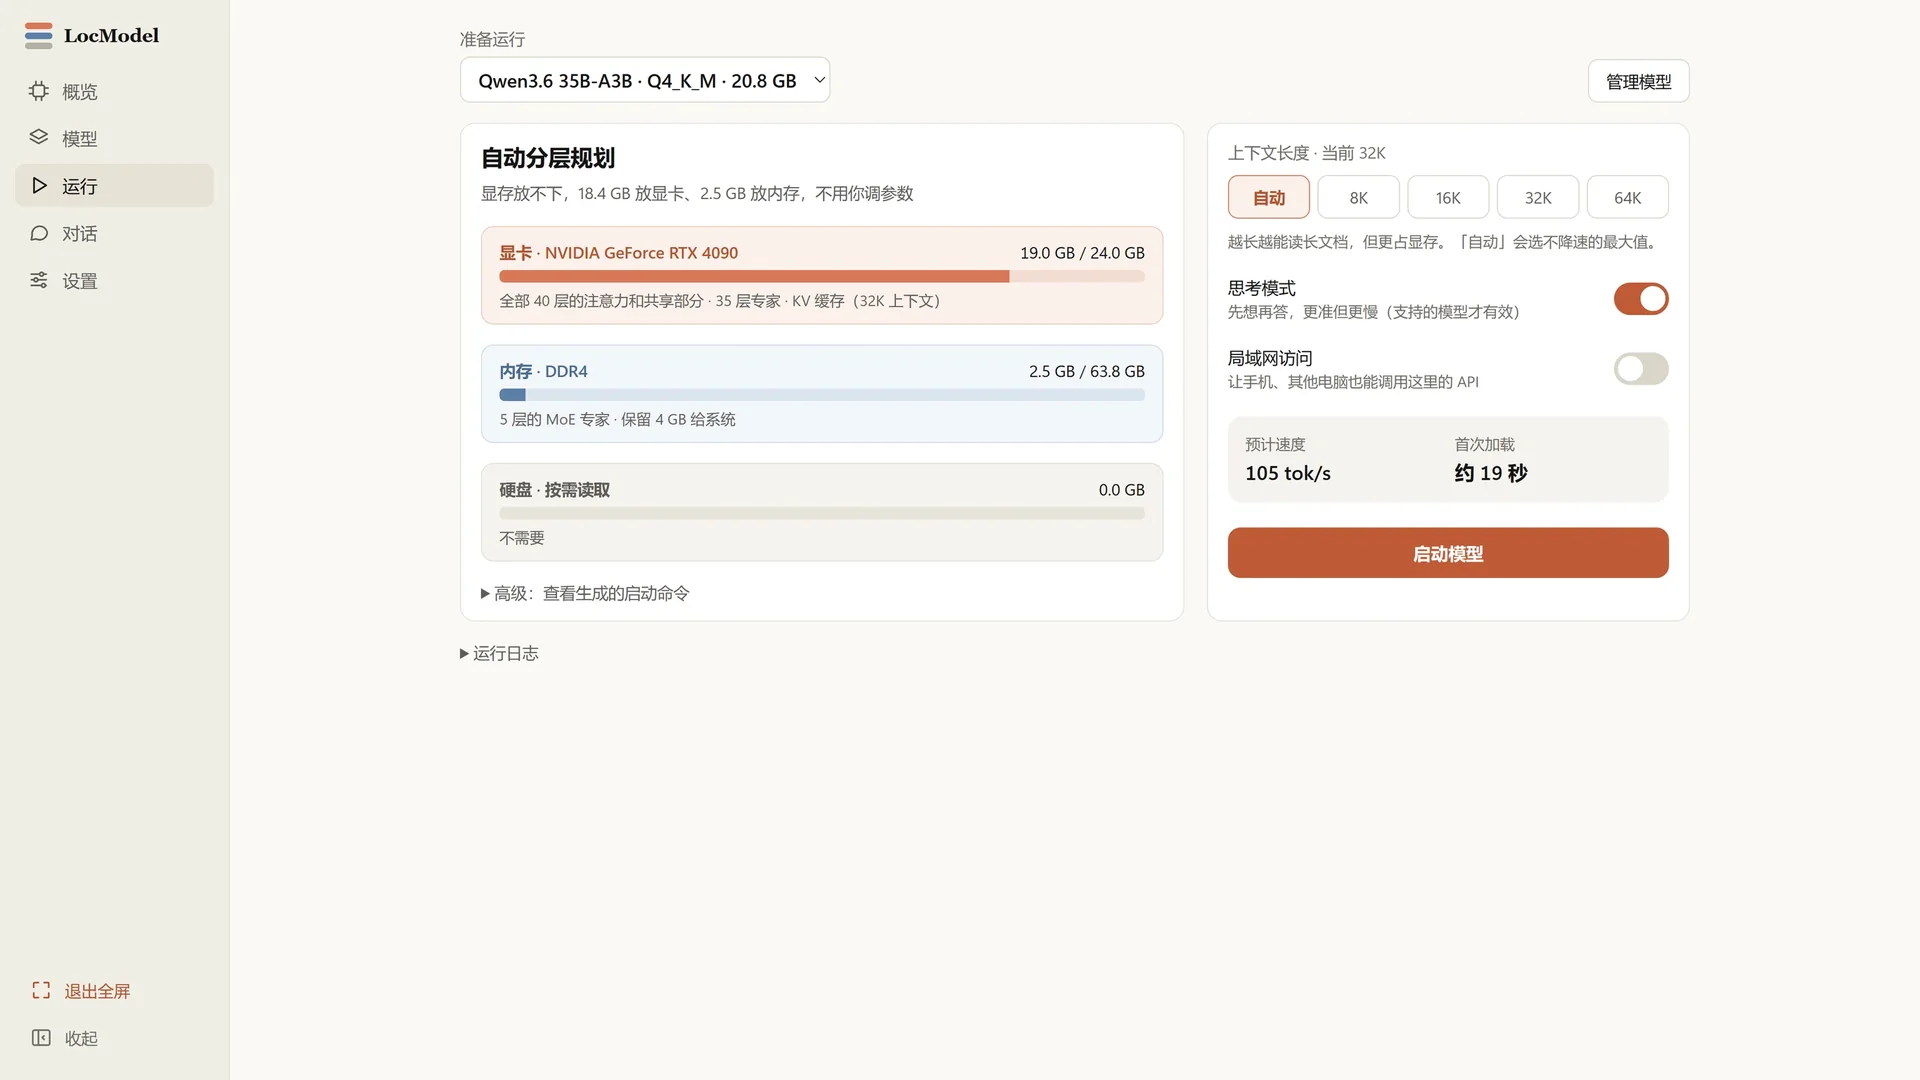
上下文长度、思考模式、局域网访问、预计速度——常用的选择都在手边,默认值已经足够好。
05 / AUTO TIERING
LocModel 会把注意力层、专家层和 KV 缓存按顺序放进显卡、内存和硬盘。越靠左越快,放不下的部分自动往后排。
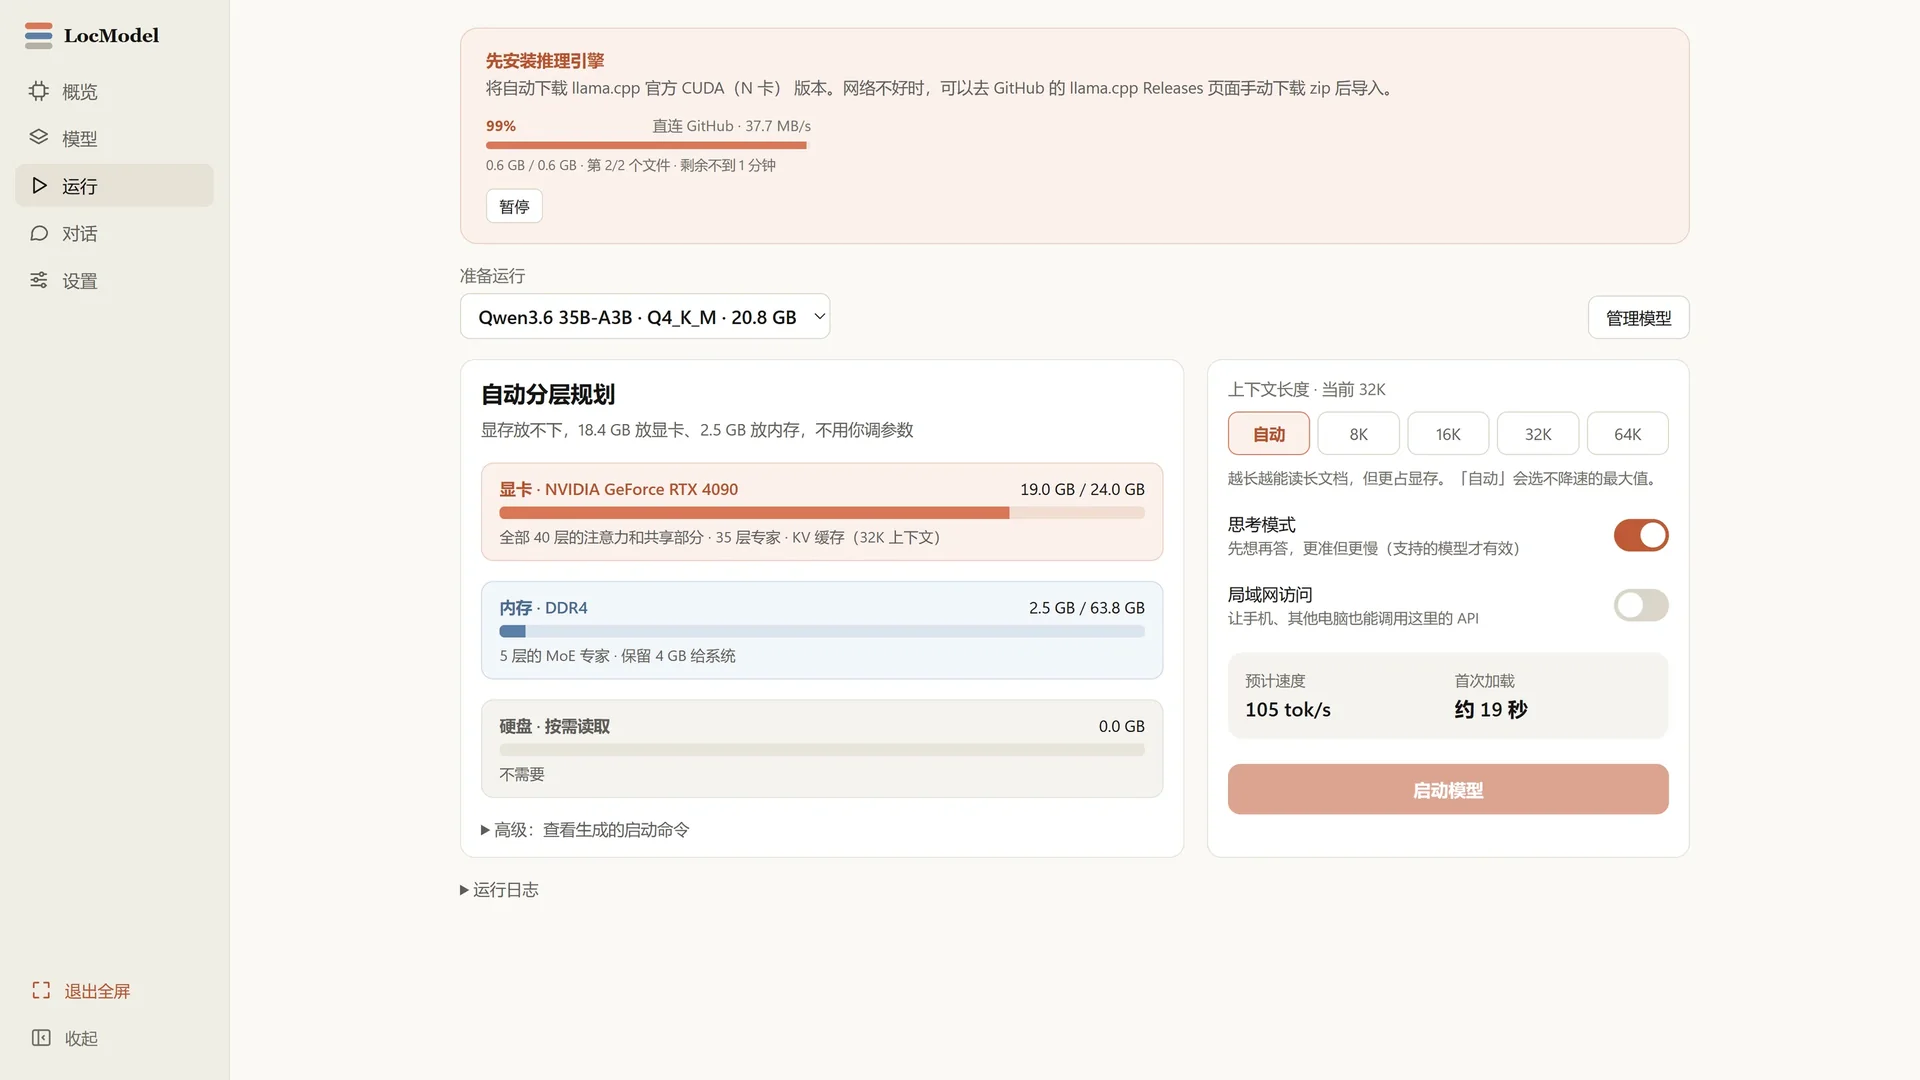
不需要调参数。LocModel 会自己算。
HOW IT WORKS
不需要命令行,不需要读一堆文档。打开 LocModel,跟着界面走就行。
自动读取显卡、处理器、内存与磁盘,生成一份能跑什么模型的清单。
匹配你的显卡,下载对应的推理后端。进度可见,随时可以暂停。
选一个模型,或在本地导入 GGUF。点下启动,开始本地推理。
COMPATIBILITY
LOCAL BY DEFAULT
没有账号,没有云端排队,没有用量限制。下载、导入、运行,全在这台电脑上完成。
DOWNLOAD
Windows 10/11 x64 · 免费 · 双击安装。下载后解压,运行安装程序即可。
LocModel_0.1.0_x64-setup.zip
v0.1.0