Lokale KI · Ein-Klick-Setupv3.1.0

Große Modelle,
auf deinen Computer.

LocModel erkennt deine Hardware, empfiehlt passende Open-Source-Modelle und installiert die Inferenz-Engine. GGUF herunterladen oder importieren, einmal klicken und lokal starten. Jetzt auch mit Bildgenerierung, Video und Agent.

Windows 10/11 · x64·NVIDIA / AMD / Intel / CPU·Daten bleiben lokal

NEW Lokale Bilder, Videos und Agent sind da. Neuigkeiten
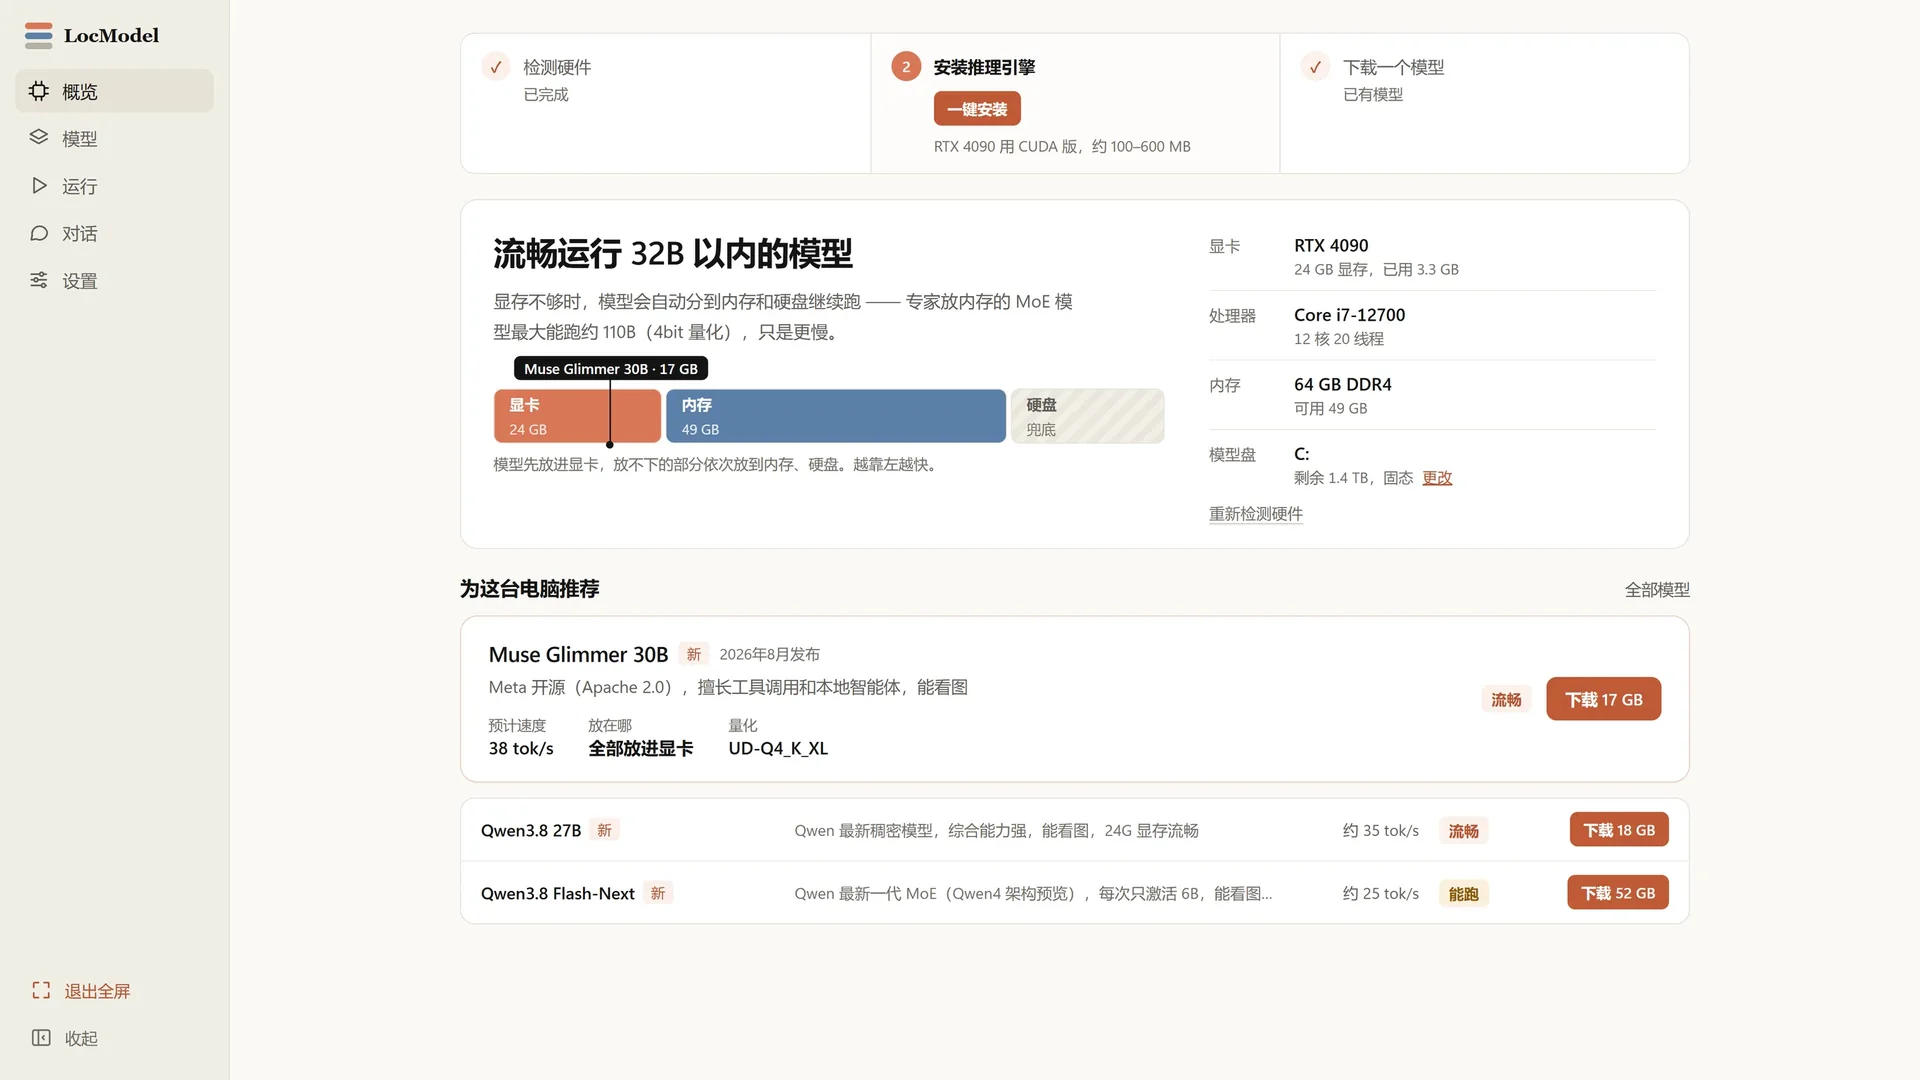
LocModel-Übersicht: Erkennt automatisch Hardware und empfiehlt Modelle, die reibungslos funktionieren

01LocModel 3.1.0 · Übersicht

1Klick-Engine-Installation
4Hardware-Backends
0Cloud-Abhängigkeit
100%Lokal

WHY LOCMODEL

Lokale KI,
sollte einfacher sein.

Keine Umgebung einrichten, keine Parameter merken. LocModel nimmt dir die schwierigen Teile ab und lässt dir die Modelle. Jetzt kommen eine Leinwand, Video und ein Agent dazu, der selbst anpackt.

01

Hardware erkennen

GPU, CPU, Arbeitsspeicher und Datenträger auf einen Blick. Du siehst sofort, welche Modelle laufen und wie schnell sie sind.

02

Engine per Klick

Wählt das passende llama.cpp-Backend automatisch – für NVIDIA, AMD, Intel und reine CPU. Selbst kompilieren ist nicht nötig.

03

Modelle frei verwalten

HuggingFace-Modelle online laden oder lokale GGUF-Dateien importieren. Deine Modelle bleiben deine – ohne Plattformbindung.

04

Intelligentes VRAM-Tiering

Passt ein Modell nicht in den VRAM, wandern einige Layer automatisch in RAM und auf die Festplatte. Große Modelle laufen trotzdem, nur etwas langsamer.

01 / HARDWARE

Es liest
deinen Computer.

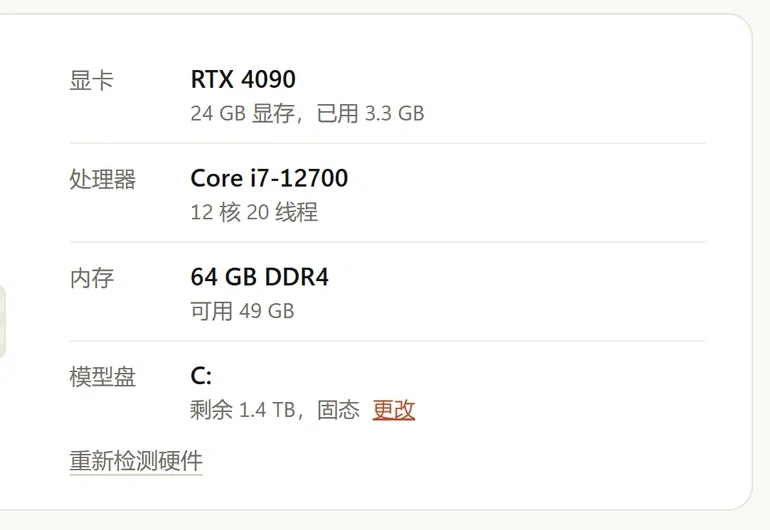
Beim Start zeigt LocModel keine Parameter, sondern einen Hardware-Check: GPU-Modell und VRAM, CPU-Kerne, verfügbarer RAM und Speicherplatz für Modelle.
  • Identifizieren Sie automatisch NVIDIA/AMD/Intel/CPU
  • Empfehlen Sie Modelle, die basierend auf Grafikspeicher und Speicher reibungslos laufen können
  • Sehen Sie sich vor dem Start die Geschwindigkeit und die erste Ladezeit an
Unterstützte Hardware anzeigen
Dieser Computer
LocModel-Hardwareerkennung: RTX 4090, Core i7-12700, 64 GB DDR4 und Informationen zur Modellfestplatte
Empfohlen
Muse Glimmer 30B 38 tok/s · 17 GB · Alles in der Grafikkarte untergebracht
LocModel installiert die Inferenz-Engine mit einem Klick, identifiziert automatisch die Grafikkarte und zeigt den Download-Fortschritt an
CUDAVulkanCPU

02 / ENGINE

Die Engine,
per Klick bereit.

LocModel lädt automatisch den passenden offiziellen llama.cpp-Build für deine GPU. Bei schlechter Verbindung kannst du das ZIP auch manuell importieren – Fortschritt, Tempo und Restzeit bleiben sichtbar.

  • Identifizieren Sie automatisch NVIDIA CUDA, AMD, Intel und CPU
  • Der Download kann angehalten werden. Sollte er fehlschlagen, können Sie es erneut versuchen.
  • Unterstützt den manuellen Import lokaler Engines und kann offline installiert werden

03 / MODELS

Modelle,
griffbereit.

Empfohlene Modelle, Onlinesuche und installierte Modelle auf einer Seite. Größe, Quantisierung, erwartete Geschwindigkeit und Eignung sind direkt sichtbar.
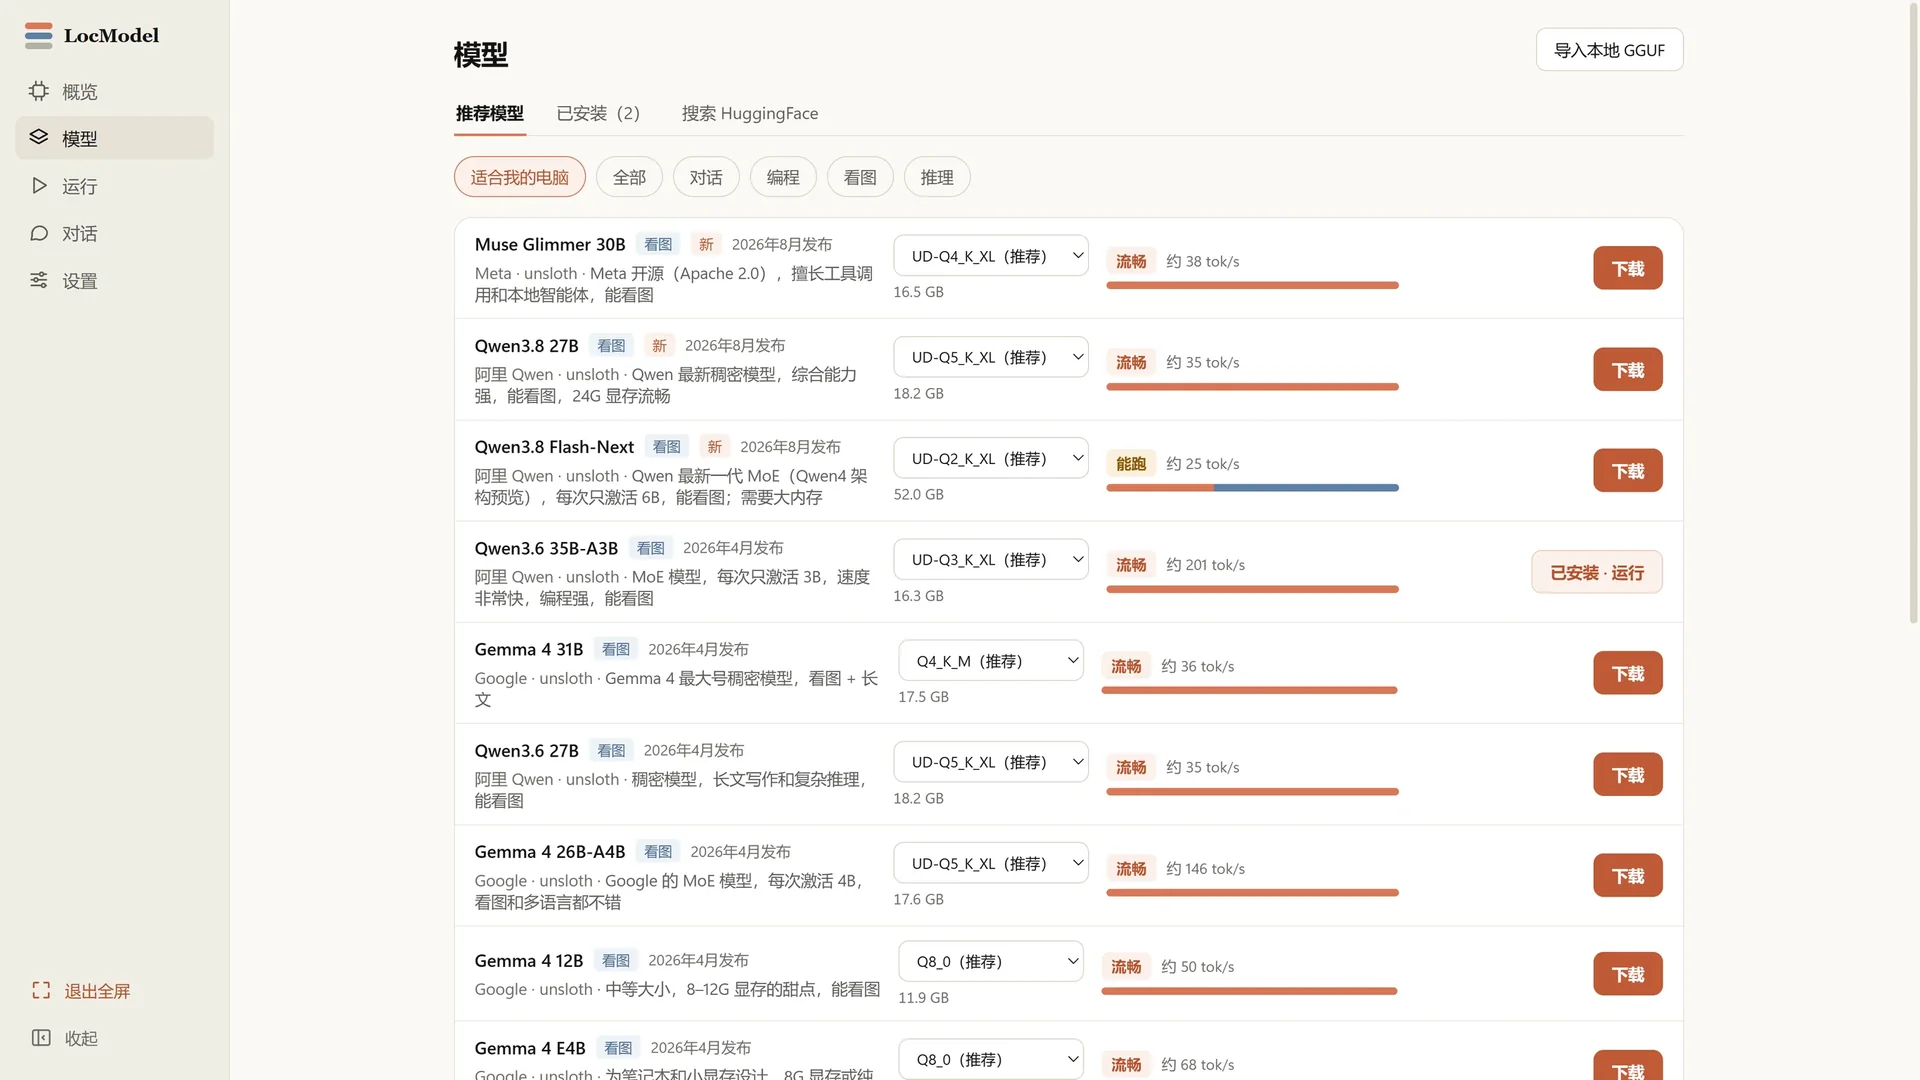
LocModel-Modellbibliothek: empfohlene Modelle, Online-Downloads, installierte Modelle und HuggingFace-Suche
A

Online-Download

Filtern Sie HuggingFace-Modelle nach Hardware und Nutzung und starten Sie den Download mit einem Klick.

B

GGUF importieren

Lokale Dateien werden direkt importiert, ohne das Format zu konvertieren oder irgendwo hochzuladen.

C

Installierte Verwaltung

Version, Größe, Quantifizierungsmethode und Laufstatus können auf einer Seite abgelesen werden.

NEW / IMAGE

Ein Prompt,
vier Bilder.

Chinesischen Prompt eingeben, Format, Schritte, Anzahl und Seed wählen. Z-Image Turbo erzeugt die Bilder direkt auf deiner GPU – ohne Upload und ohne Warteschlange.
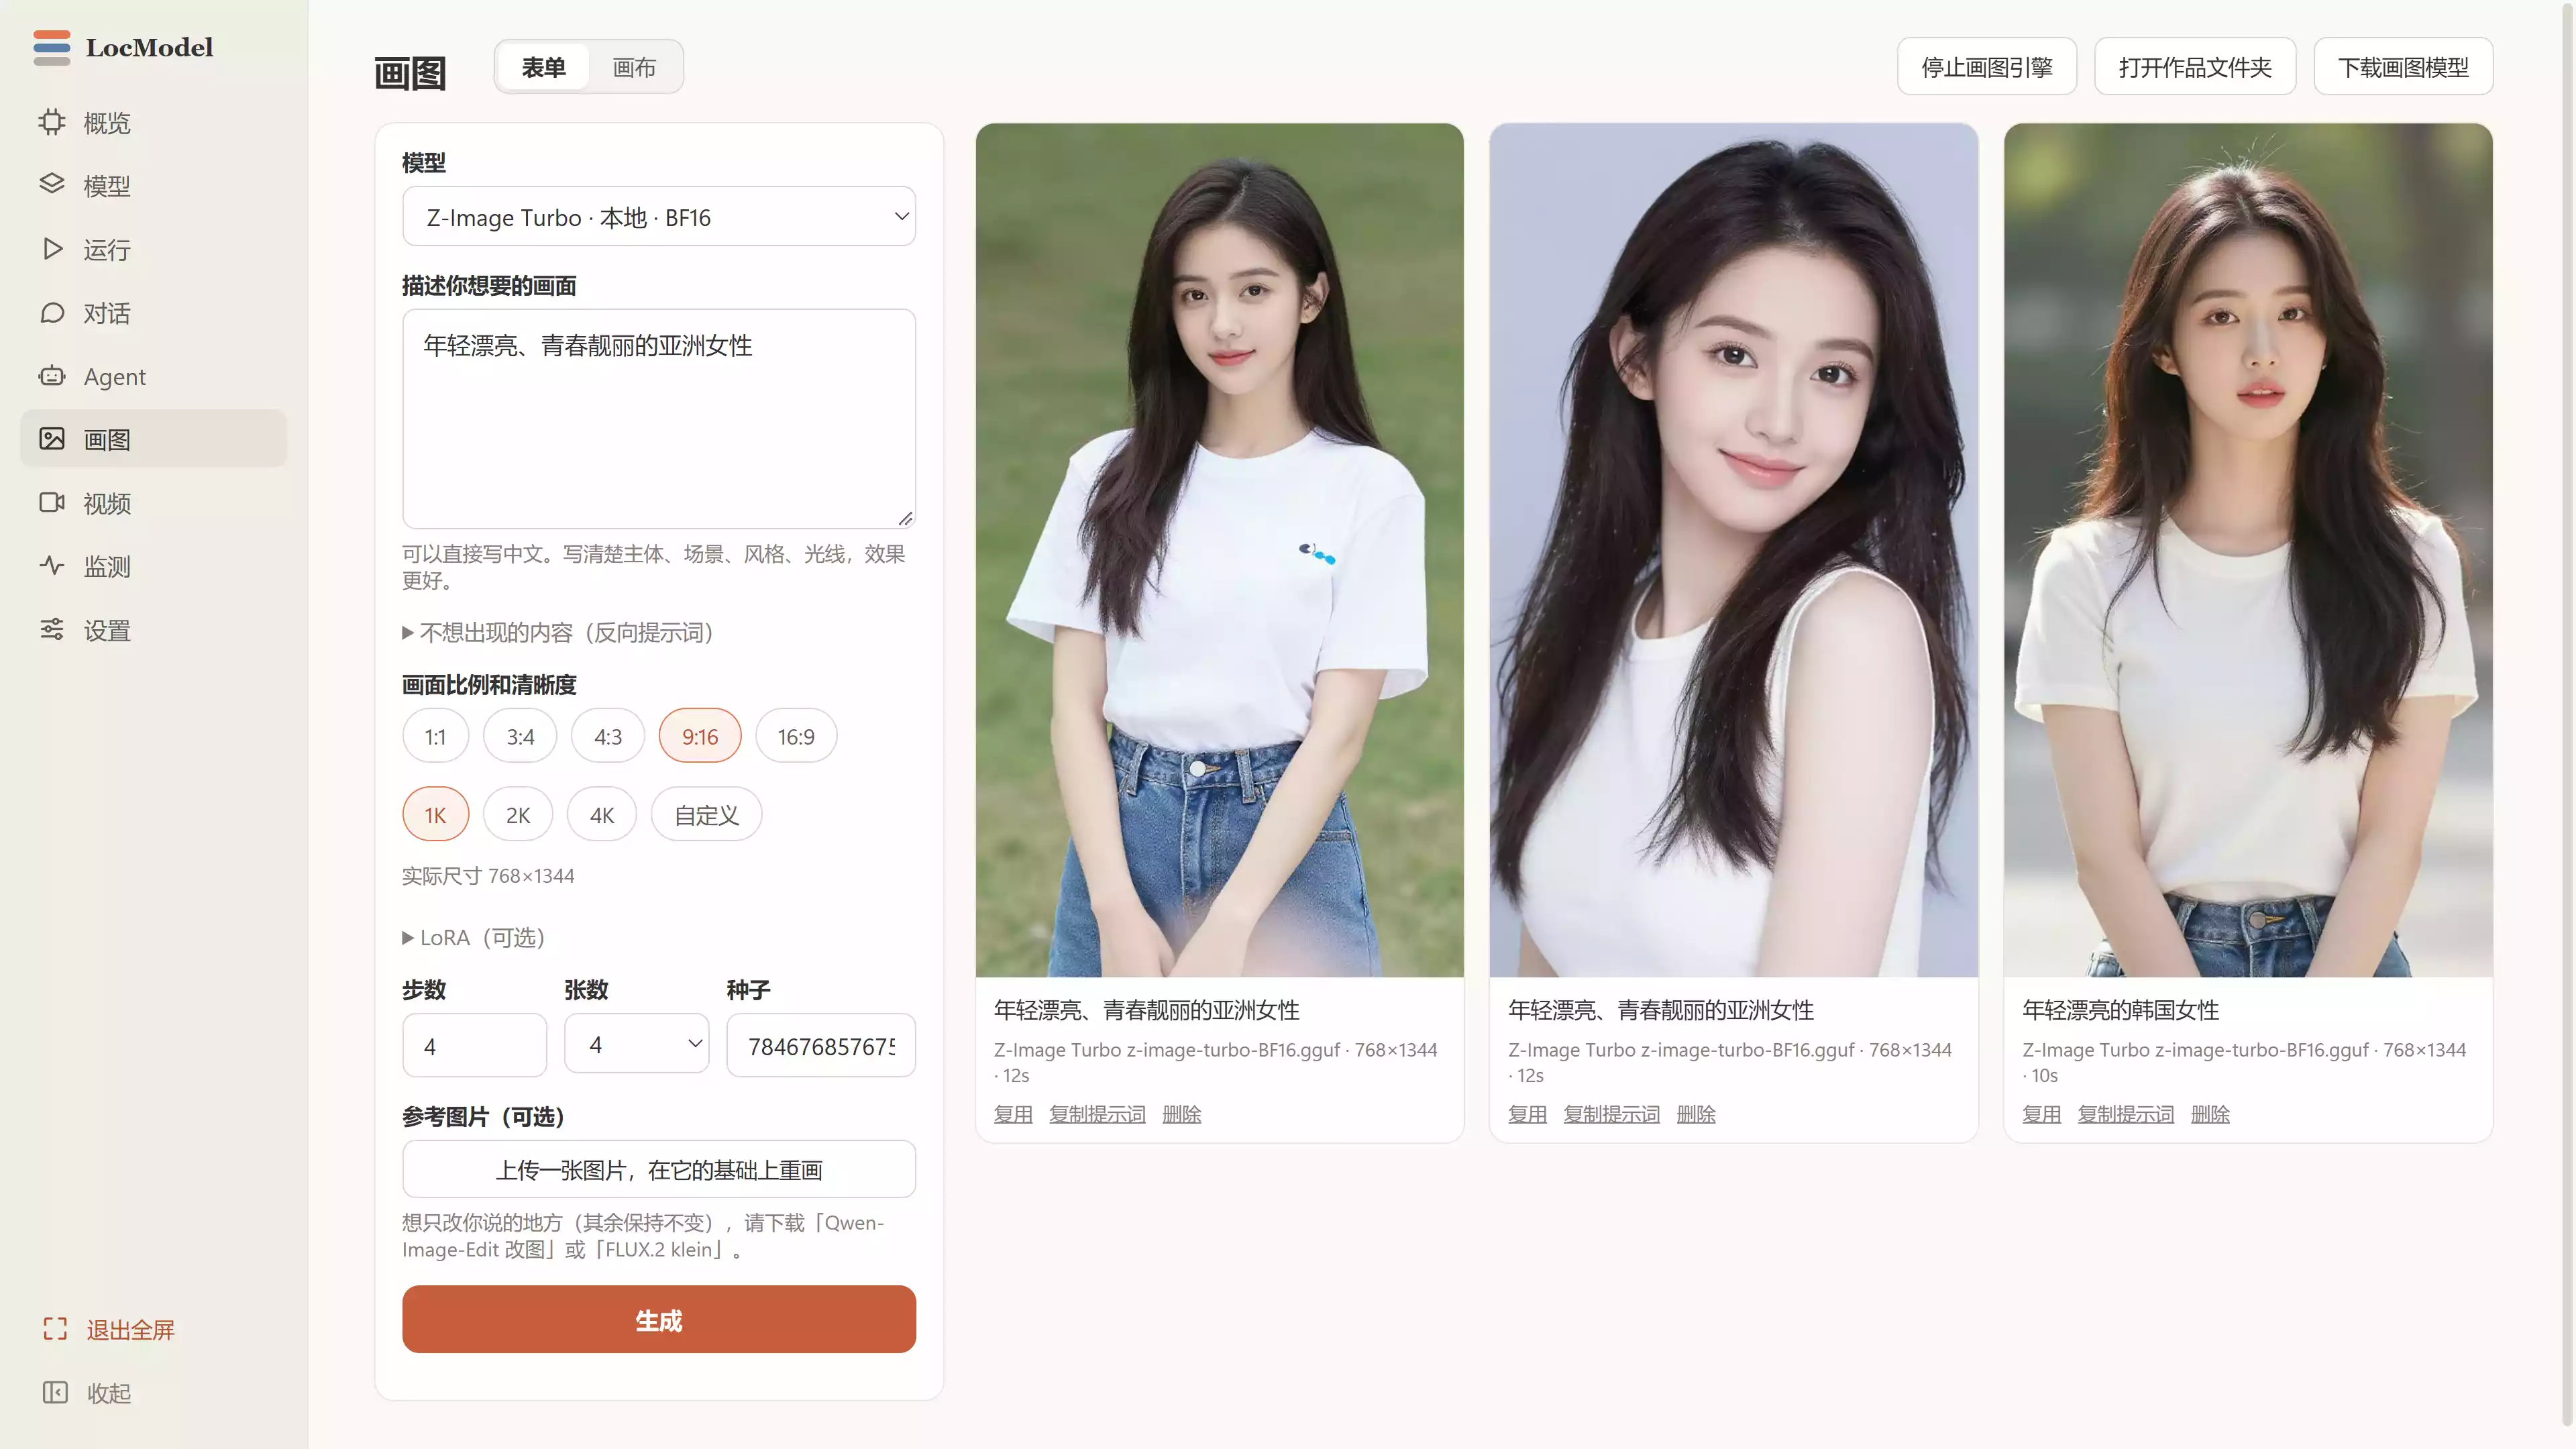
  • Das Thema, die Szene, der Stil und das Licht können alle auf Chinesisch beschrieben werden
  • 1:1, 3:4, 4:3, 9:16, 16:9 fünf Formate
  • Die Anzahl der Schritte, Blätter und Samen ist einstellbar und es können zufriedenstellende Ergebnisse reproduziert werden.
  • Unterstützt das Neuzeichnen von Referenzbildern und nimmt weiterhin Änderungen am Originalbild vor
Z-Image TurboZ-Image EditFLUX.2 kleinLokales Denken
Lokale Zeichenschnittstelle von LocModel: Chinesische Eingabeaufforderungswörter, Rahmen, Anzahl der Schritte, Anzahl der Bilder, Samen und lokal generierte Porträts

Farbe · Z-Image Turbo · 768 × 1344 · Lokal generiert
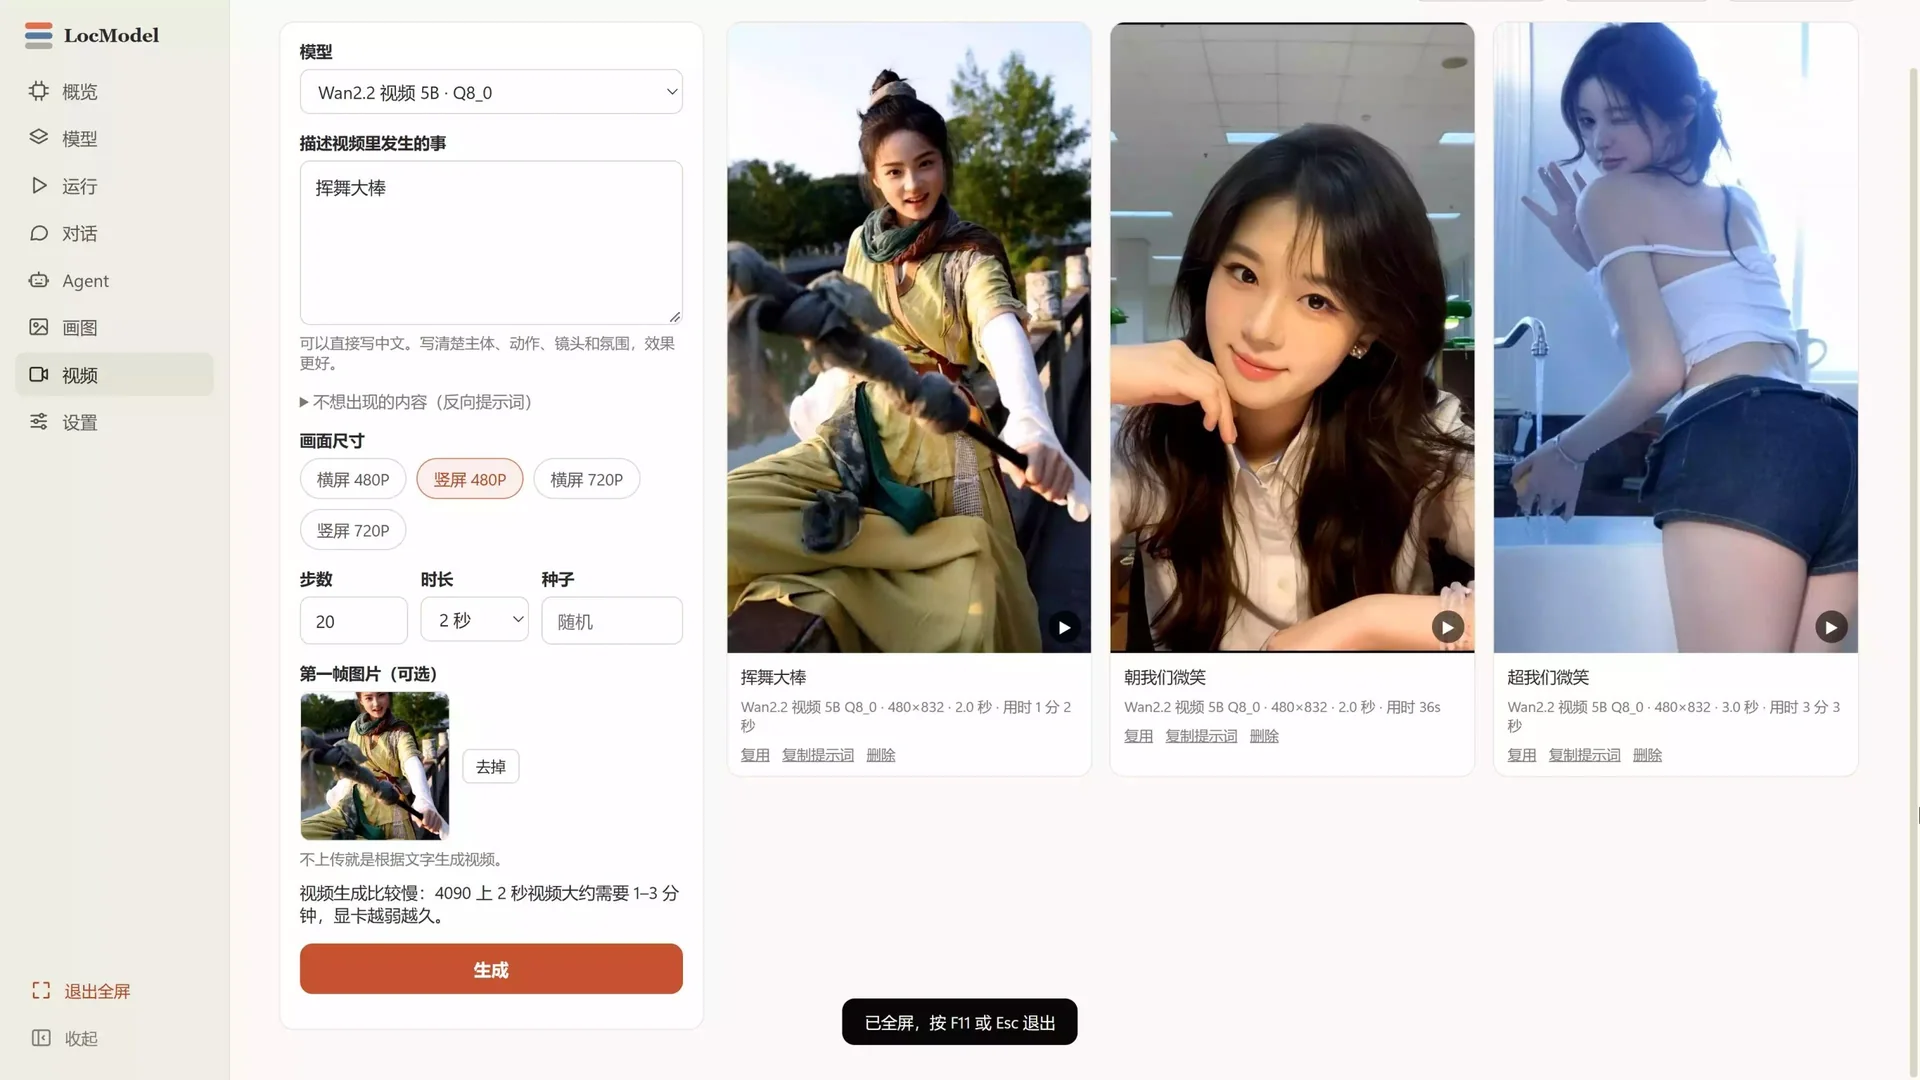
Schnittstelle zur lokalen Videogenerierung von LocModel: Wan2.2-Modell, Aufforderungswörter, horizontale und vertikale Bildschirmgrößen, Dauer und vertikale Videoergebnisse

Video · Wan2.2-Video 5B · Vertikaler Bildschirm 480P · Lokal generiert

NEW / VIDEO

Bilder,
in Bewegung.

Motiv, Bewegung, Kameraführung und Stimmung beschreiben, Wan2.2 macht daraus ein kurzes Video. Du kannst auch ein Startbild vorgeben und die Szene fortsetzen.

  • Text kann direkt in ein Video generiert werden oder der erste Frame kann hochgeladen werden, um mit dem Schreiben fortzufahren.
  • Quer-/Hochformat-Bildschirm, 480P und 720P optional
  • Dauer, Anzahl der Schritte, Seeds und umgekehrte Eingabeaufforderungswörter können angepasst werden
  • Der Generierungsfortschritt und der Zeitverbrauch werden direkt angezeigt, sodass Sie nicht blind warten müssen.
Wan2.2-Video 5BVincent VideoTusheng-VideoVertikaler Bildschirm 480P / 720P

04 / RUN

Die Einstellungen
sind schon berechnet.

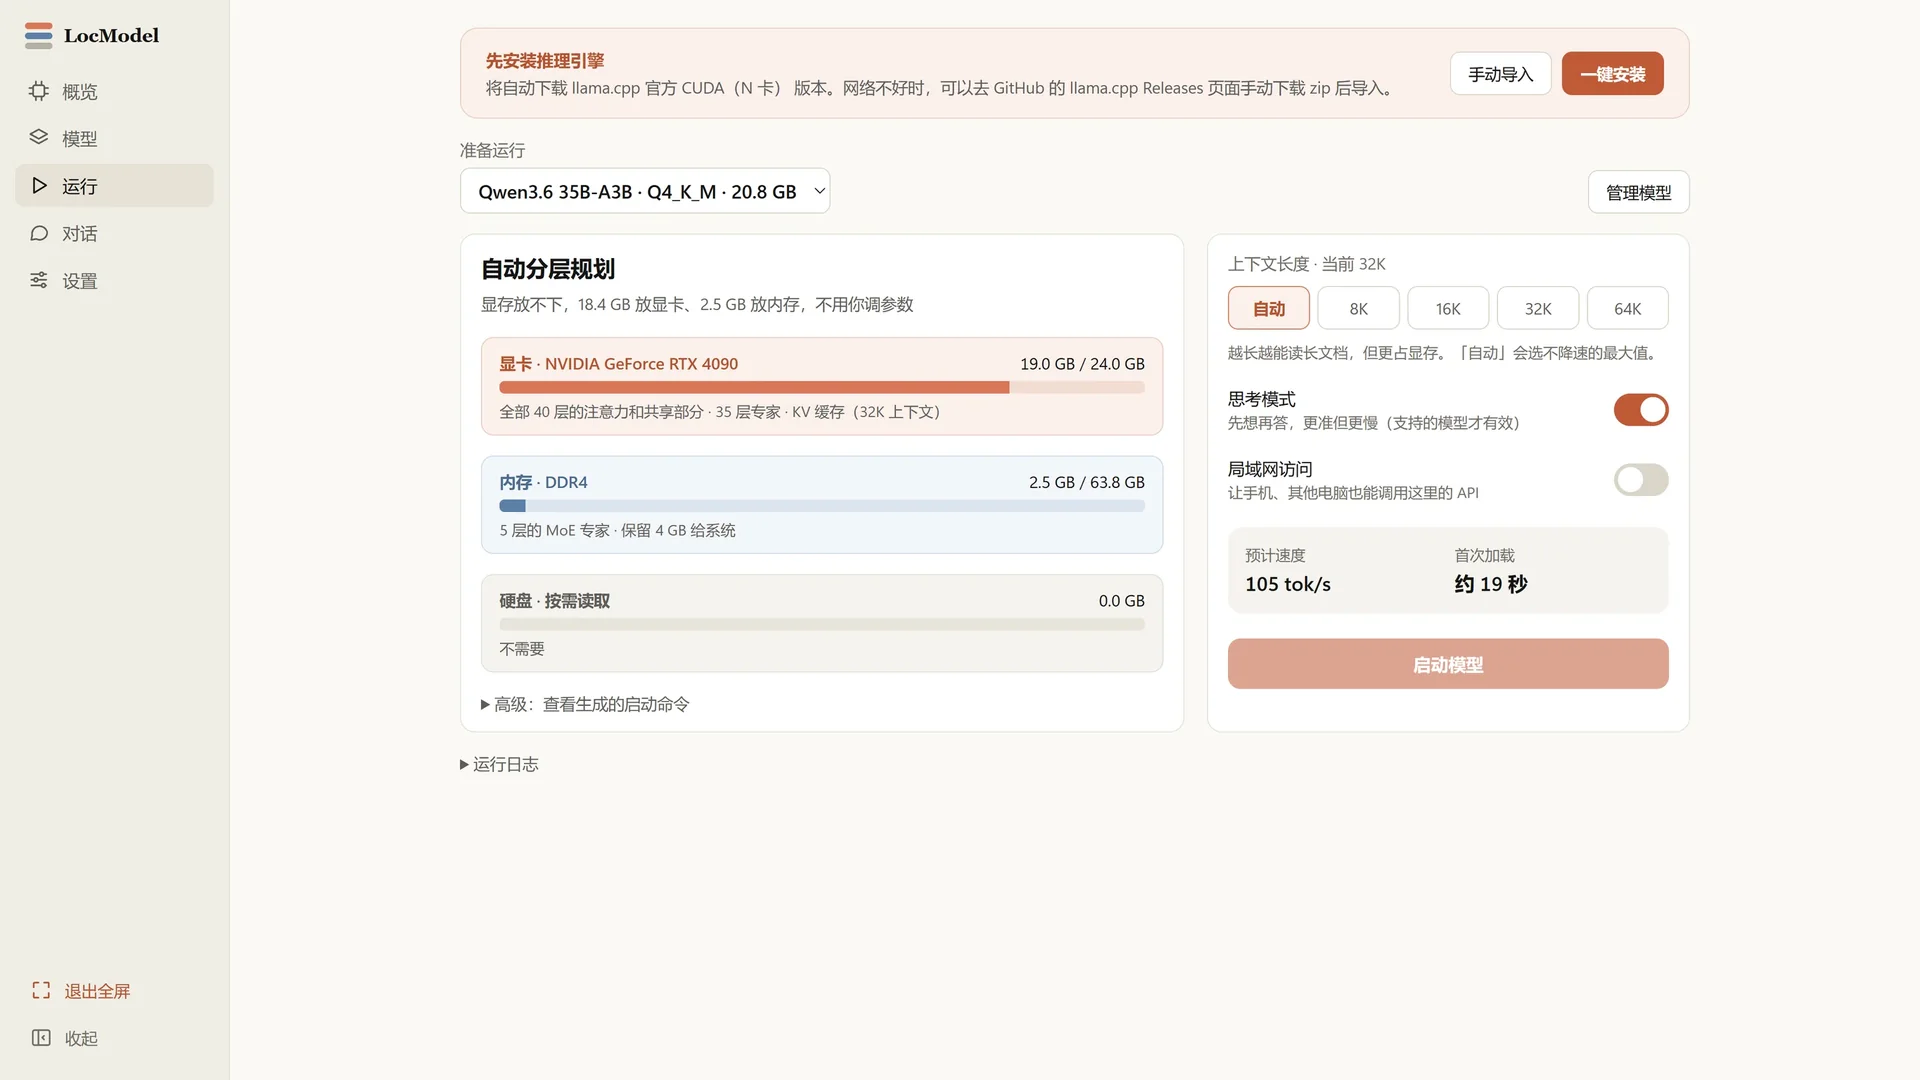
Kontextlänge, Denkmodus, LAN-Zugriff und erwartete Geschwindigkeit – die wichtigen Optionen sind griffbereit. Die Standardwerte reichen bereits.
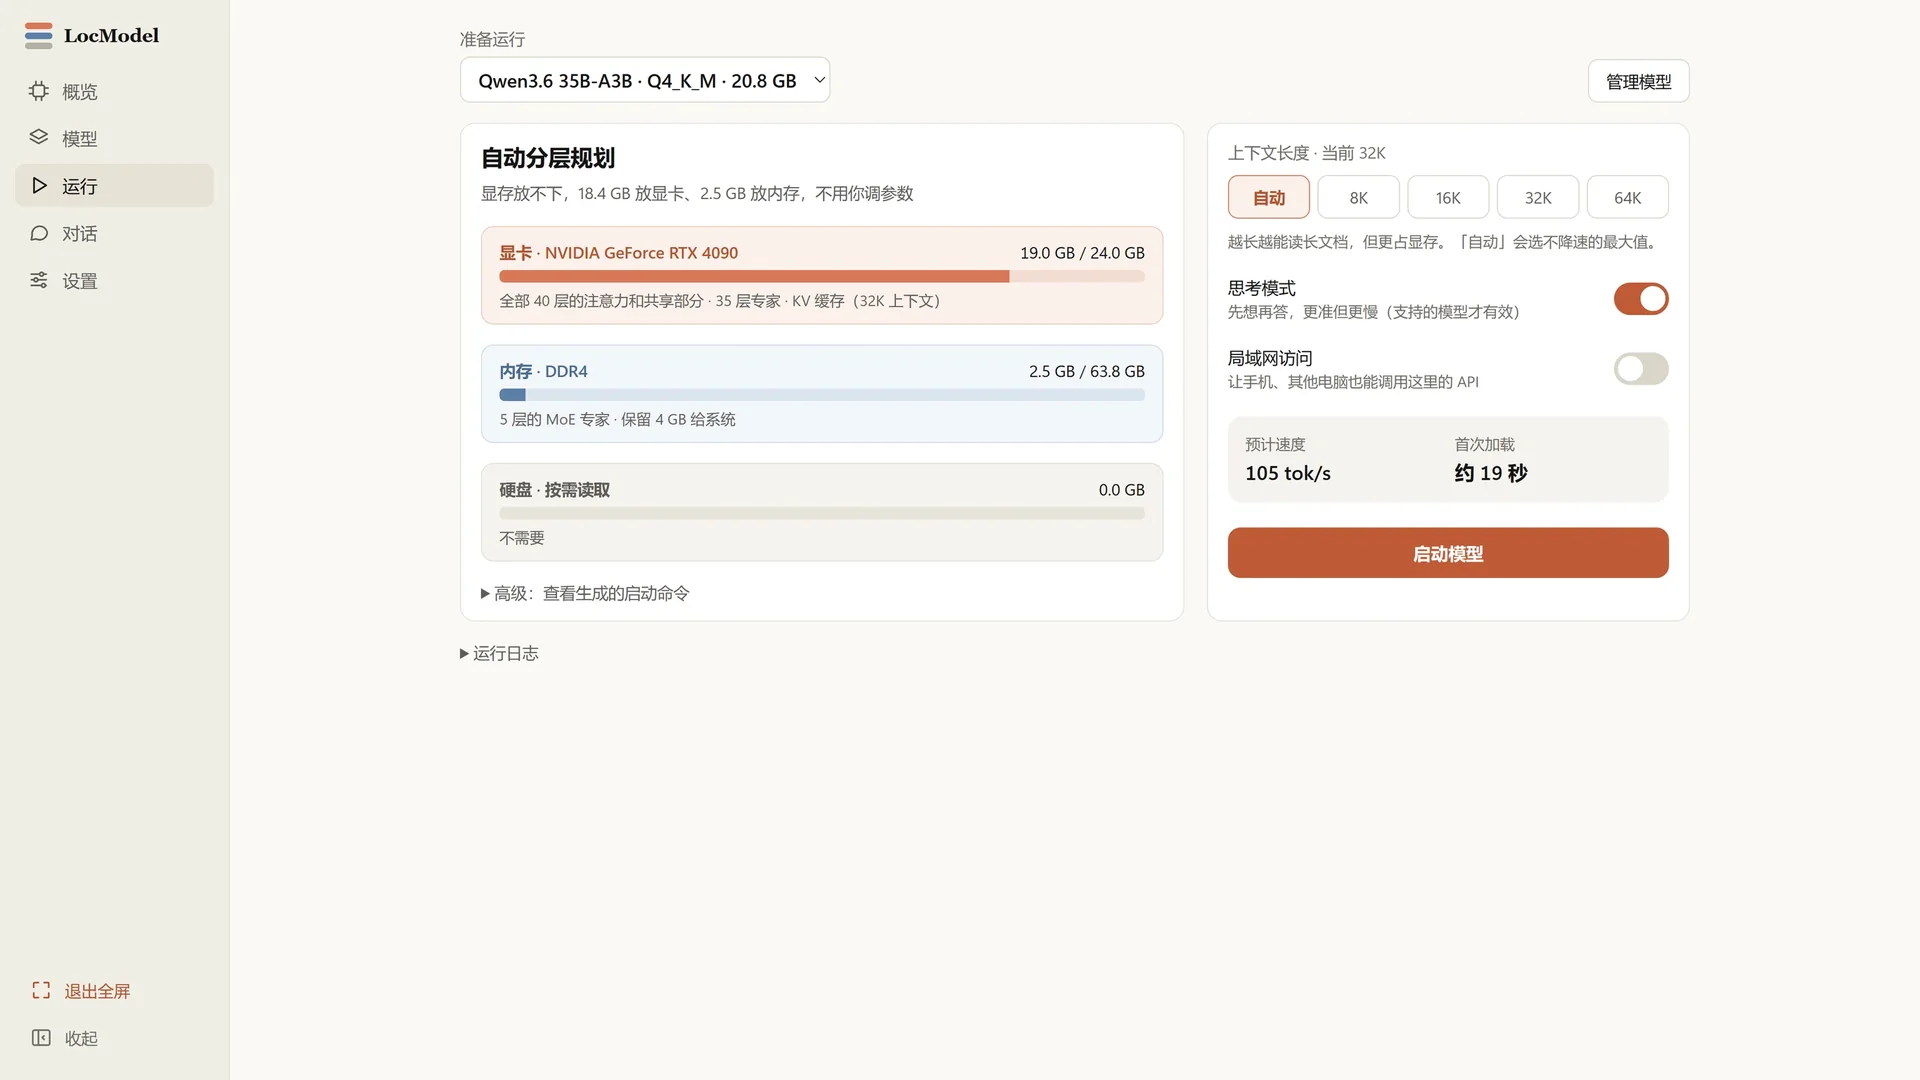
  • 8K / 16K / 32K / 64K-Kontextwechsel mit einem Klick
  • Denkendes Modell: Lassen Sie das Modell zuerst nachdenken, bevor Sie antworten
  • LAN-Zugang, Mobiltelefone und andere Computer können ebenfalls anrufen
LocModel-Startmodell: Kontextlänge, Denkmodus, LAN-Zugriff, geschätzte Geschwindigkeit und erste Ladezeit
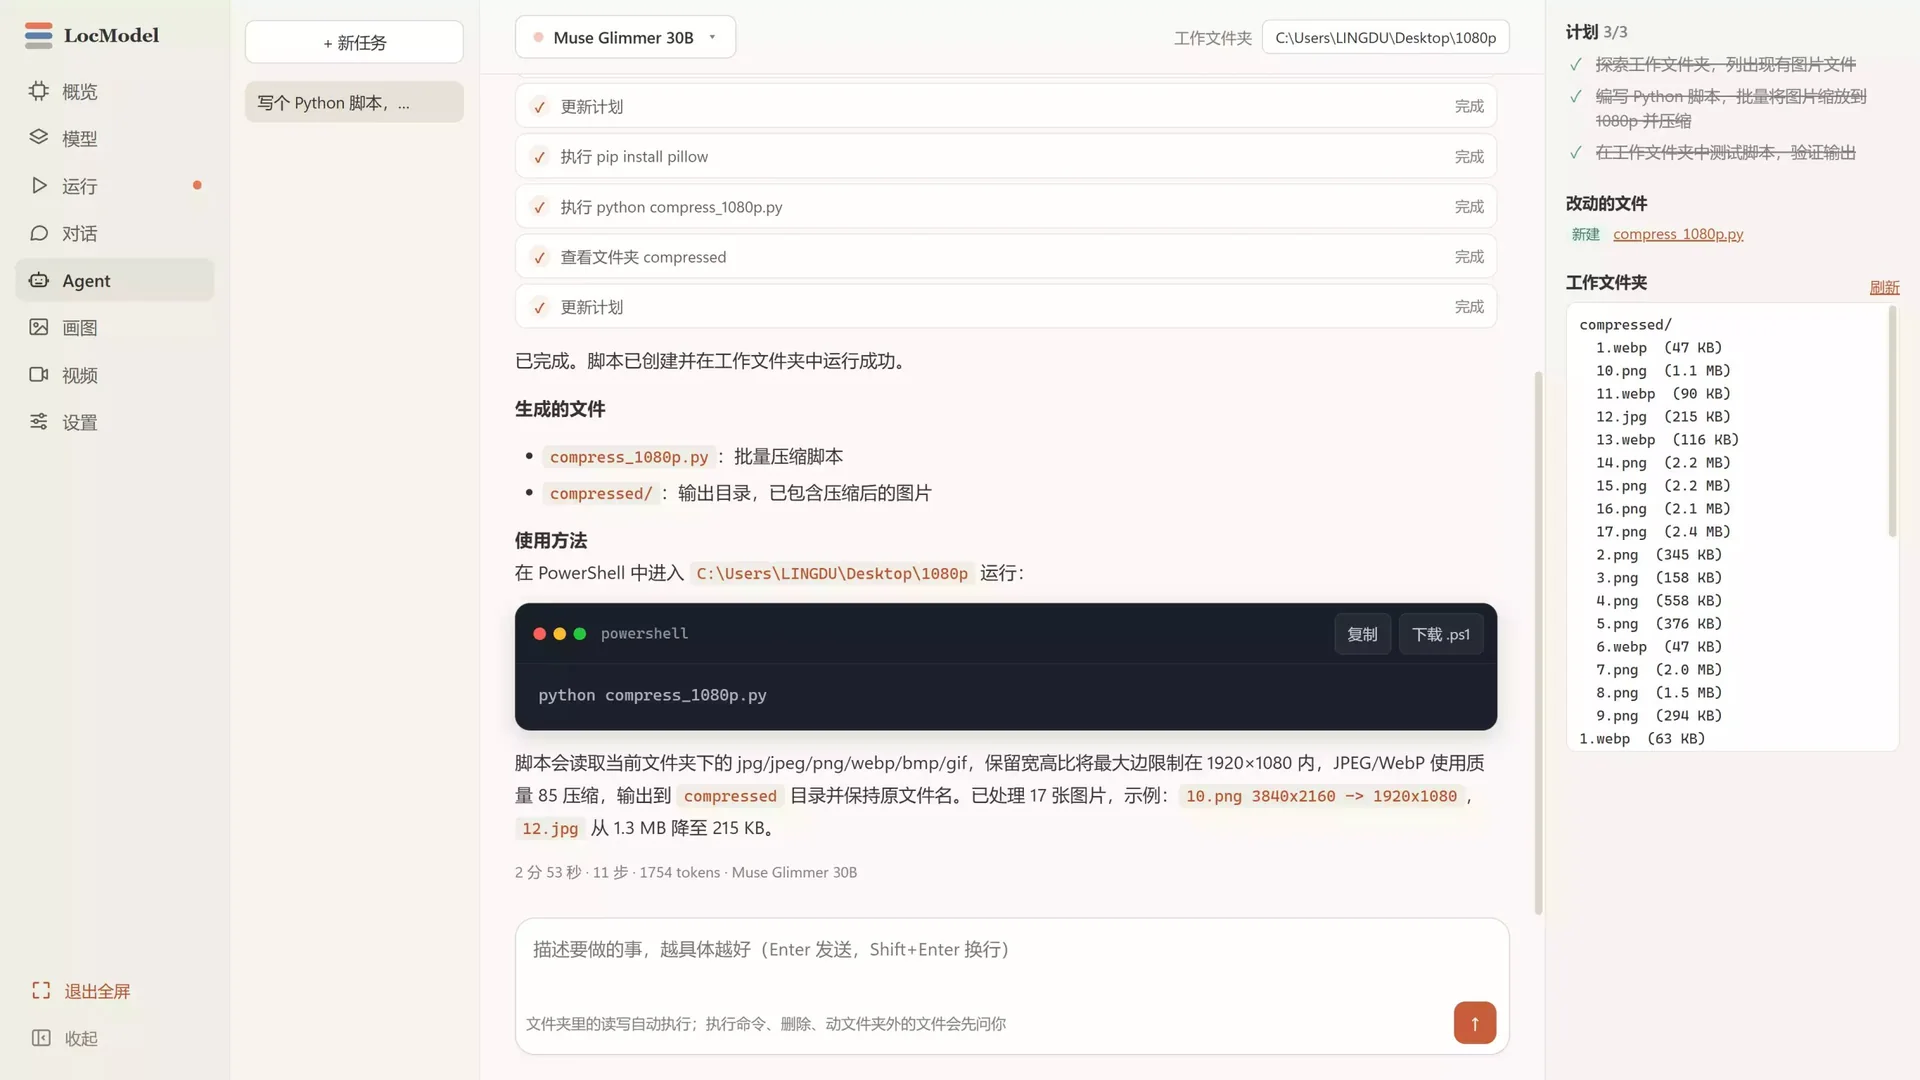
LocModel-Agentenschnittstelle: Taskplaner, PowerShell-Befehle, Makefiles und Arbeitsordnerlisten

Agent · Muse Glimmer 30B · 11 Schritte · 2 Minuten 53 Sekunden

NEW / AGENT

Ein Auftrag genügt,
und es legt los.

Gib einen Arbeitsordner an: Der Agent plant, liest und schreibt Dateien, erstellt Skripte und führt Befehle aus. Jeder Schritt wird aktualisiert, am Ende stehen die Ergebnisse.

  • Erstellen Sie automatisch Pläne, führen Sie diese Schritt für Schritt aus und aktualisieren Sie den Fortschritt
  • Lesen und schreiben Sie in Ordnern, führen Sie Python/PowerShell aus
  • Fragen Sie nach, bevor Sie Inhalte außerhalb des Ordners löschen, verschieben oder darauf zugreifen
  • Überprüfen Sie nach Abschluss die Ausgabe und antworten Sie nicht nur „Es sollte in Ordnung sein“.

Automatisch innerhalb des Ordners ausführen · Fragen Sie zuerst außerhalb des Ordners

Muse Glimmer 30BAgent, lokal ausgeführtLesen und Schreiben von DateienBefehlsausführung

NEW / CHAT & CODE

Erst reden,
dann schreiben.

Von der Frage zum lauffähigen Skript. Das lokale Modell liest Anhänge, schreibt Code und erklärt den Ansatz. Codeblöcke lassen sich mit einem Klick kopieren oder herunterladen.
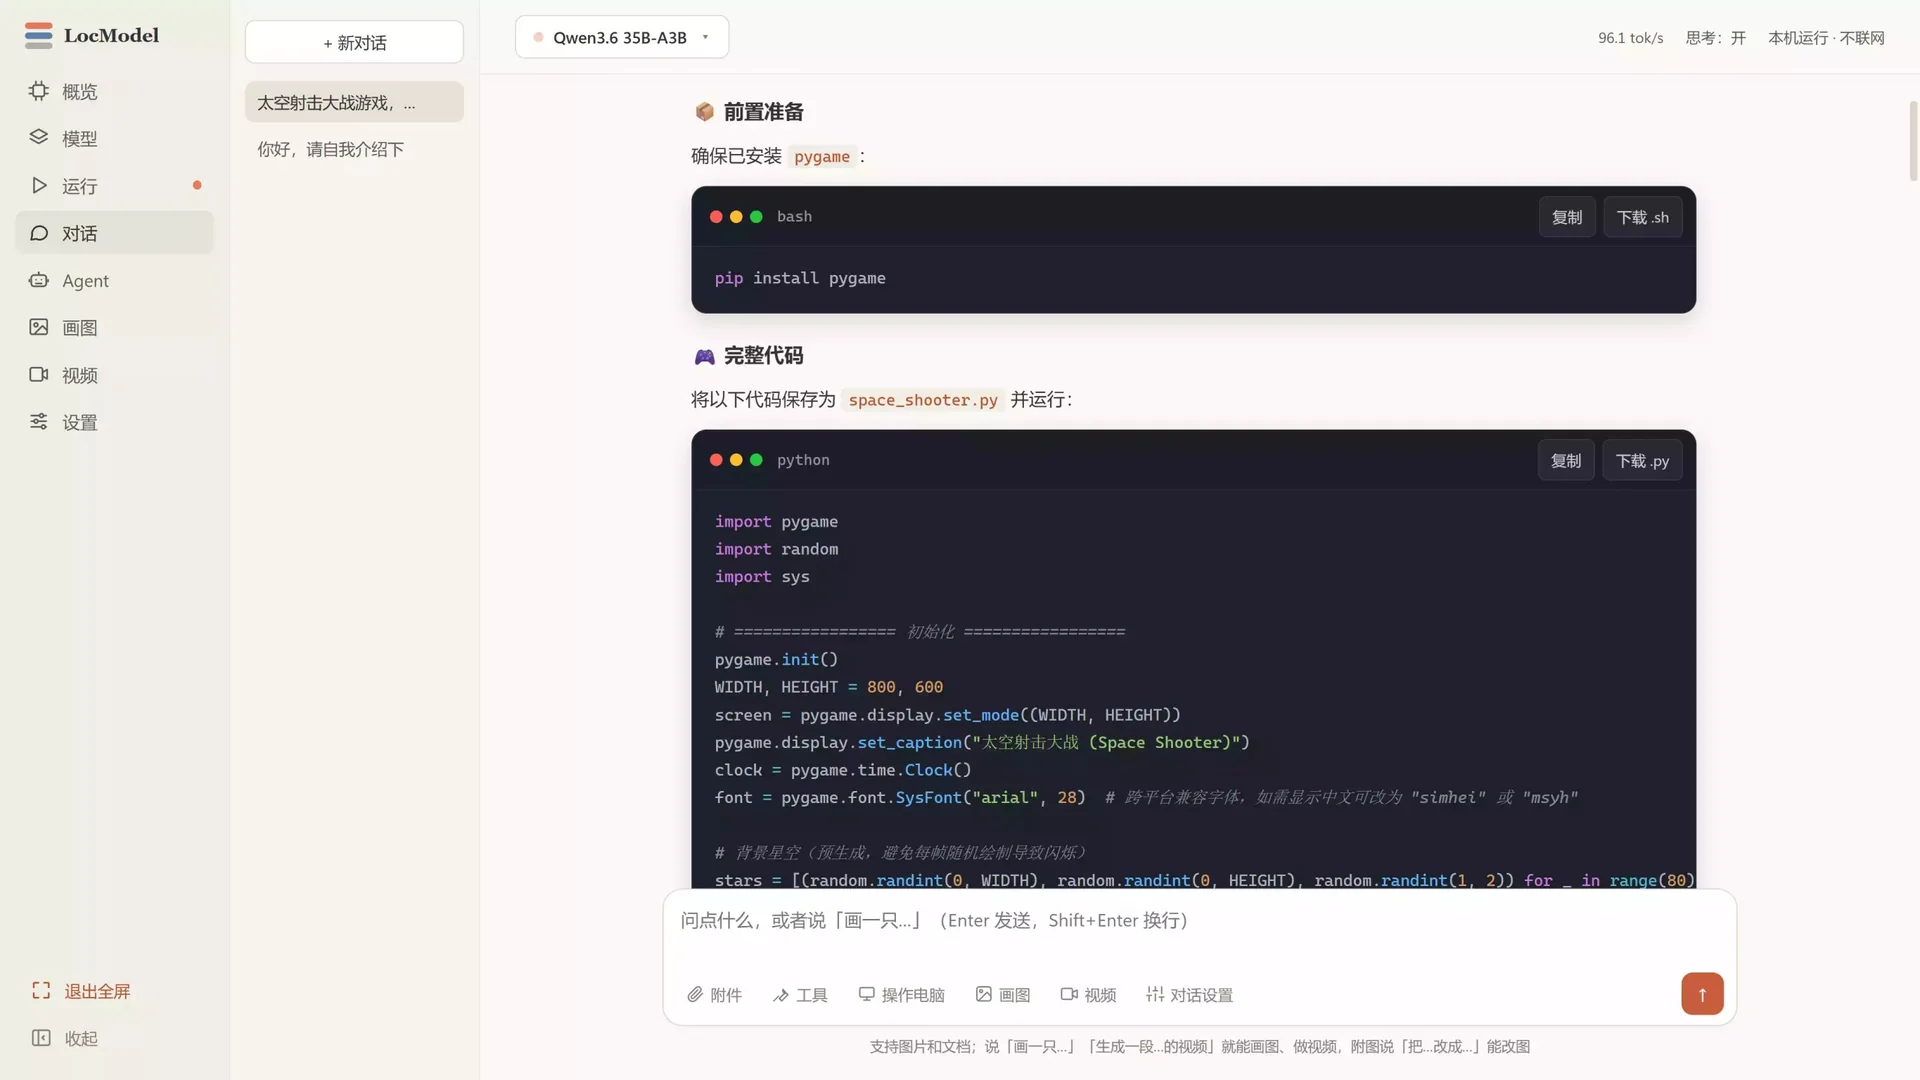
  • Mehrstufiger Dialog, unterstützende Anhänge, Dokumente und langer Kontext
  • Kopieren/Herunterladen der Codeblöcke .py/.sh mit einem Klick
  • Denkmuster, Tok/s und Kontextlänge sind alle sichtbar
  • Der gesamte Prozess ist eine lokale Argumentation und kann auch dann fortgesetzt werden, wenn die Netzwerkverbindung unterbrochen ist.
Qwen3.6 35B-A3B96.1 tok/sDenkmodellLokal · Nicht mit dem Internet verbunden
Lokale Dialogschnittstelle von LocModel: Qwen3.6 generiert den vollständigen Code des Pygame-Weltraumschießspiels. Die Codeblöcke können kopiert und heruntergeladen werden.

Dialog und Code · Qwen3.6 35B-A3B · 96,1 tok/s

05 / AUTO TIERING

Zu wenig VRAM?
Kein Problem.

LocModel verteilt Attention-Layer, Experten-Layer und KV-Cache auf GPU, RAM und Festplatte. Weiter links ist schneller; was nicht passt, wandert automatisch nach hinten.
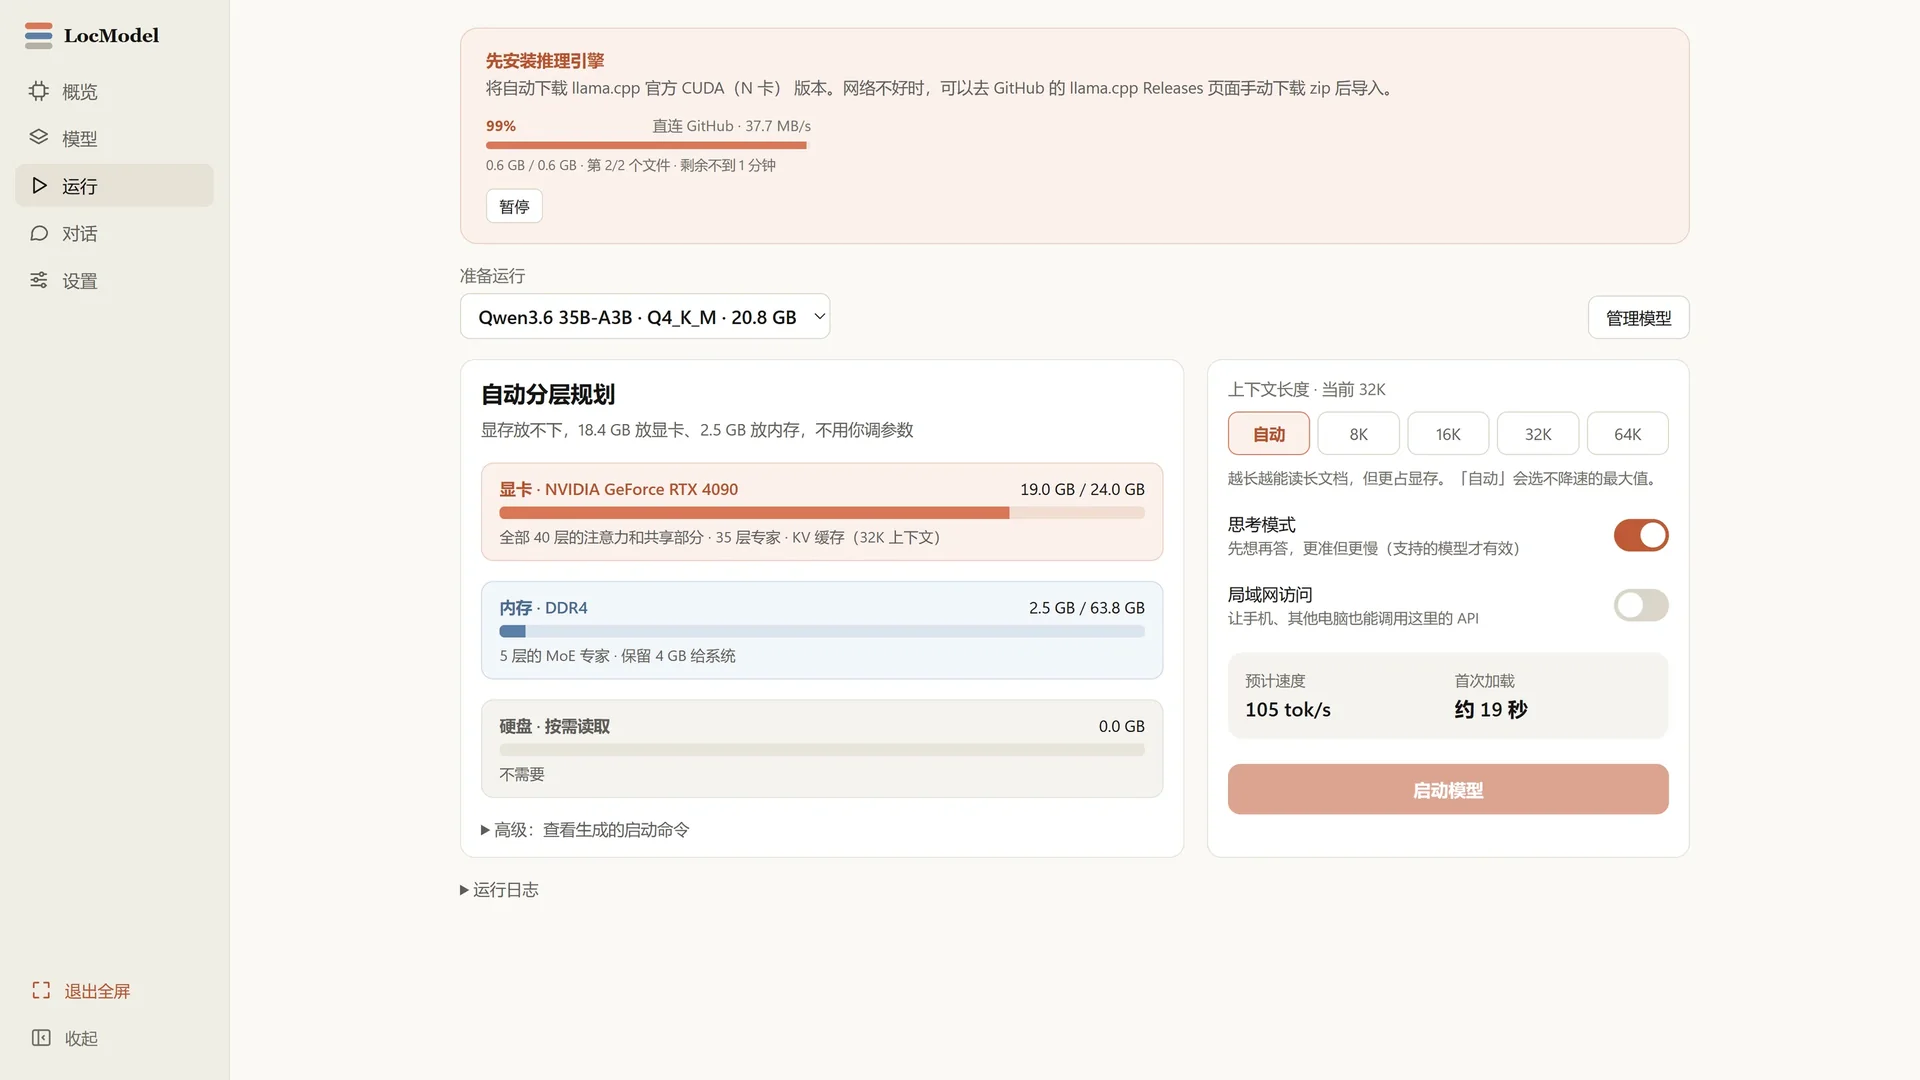
Grafikkarte · RTX 409019.0 / 24.0 GB
Achtung / Gemeinsamer Abschnitt / KV-Cache
Speicher · DDR42.5 / 63.8 GB
Layer 5 MoE Expert · Reservieren Sie 4 GB für das System
Festplatte · Lesen auf Abruf0.0 GB
Es kommt nur dann zum Einsatz, wenn es nicht abgelegt werden kann. Kapazität wird durch Geschwindigkeit ersetzt.
Automatische hierarchische Planung von LocModel: Speicherzuweisung von Grafikkarten, Speicher und Festplatten sowie Download-Fortschritt der Inferenz-Engine

Keine Notwendigkeit, Parameter anzupassen. LocModel übernimmt die Berechnung selbst.

HOW IT WORKS

Drei Schritte,
von null bis zum Start.

Keine Kommandozeile, keine Dokumentation. LocModel öffnen und der Oberfläche folgen.

01

Hardware erkennen

Liest automatisch die Grafikkarte, den Prozessor, den Speicher und die Festplatte und erstellt eine Liste der lauffähigen Modelle.

02

Motor einbauen

Passen Sie Ihre Grafikkarte an und laden Sie das entsprechende Inferenz-Backend herunter. Der Fortschritt ist sichtbar und kann jederzeit pausiert werden.

03

Herunterladen und starten

Wählen Sie ein Modell aus oder importieren Sie GGUF lokal. Klicken Sie auf „Start“, um die lokale Inferenz zu starten. Sie können auch direkt Bilder zeichnen, Videos erstellen oder Aufgaben an den Agenten übergeben.

COMPATIBILITY

Von CPU bis RTX 5090,
ist alles dabei.

NVIDIA CUDA AMD Intel CPU Windows 10/11 x64 GGUF HuggingFace Z-Image Wan2.2 Agent

LOCAL BY DEFAULT

Modelle lokal,
Daten bleiben zu Hause.

Kein Konto, keine Cloud-Warteschlange, kein Nutzungslimit. Download, Import und Ausführung bleiben auf diesem Rechner. Bilder, Videos und Agent-Aufgaben ebenfalls.

  • Sie müssen sich nicht anmelden, öffnen Sie es einfach und verwenden Sie es
  • Aufforderungsworte, Referenzbilder sowie generierte Bilder und Videos verlassen die Maschine nicht
  • Argumentieren, Zeichnen, Erstellen von Videos und Ausführen des Agenten können auch offline erfolgen

DOWNLOAD

Setzen Sie LocModel
Installieren Sie es auf Ihrem Computer.

Windows 10/11 x64 · Kostenlos · Installation per Doppelklick. Windows ist die Hauptplattform; macOS und Linux sind ebenfalls verfügbar.

LocModel_3.1.0_x64-setup.exe v3.1.0

OTHER PLATFORMS

Windows ist primär · macOS / Linux verfügbar
Erster Start unter macOS

Noch kein Zertifikat. Nach dem Download mit Rechtsklick → Öffnen starten. Falls die Installation scheitert, im Terminal ausführen:

sudo xattr -rd com.apple.quarantine /Applications/LocModel.app