本地大模型 · 一键部署v3.1.0

把大模型,
请进你的电脑。

LocModel 自动看懂你的硬件,推荐合适的开源模型,装好推理引擎。在线下载或导入 GGUF,点一下,就在本地跑起来。现在,它也学会了画图、生成视频和替你动手。

Windows 10/11 · x64·NVIDIA / AMD / Intel / CPU·数据留在本地

NEW 本地画图、视频生成与 Agent 本地调用已加入 查看新能力
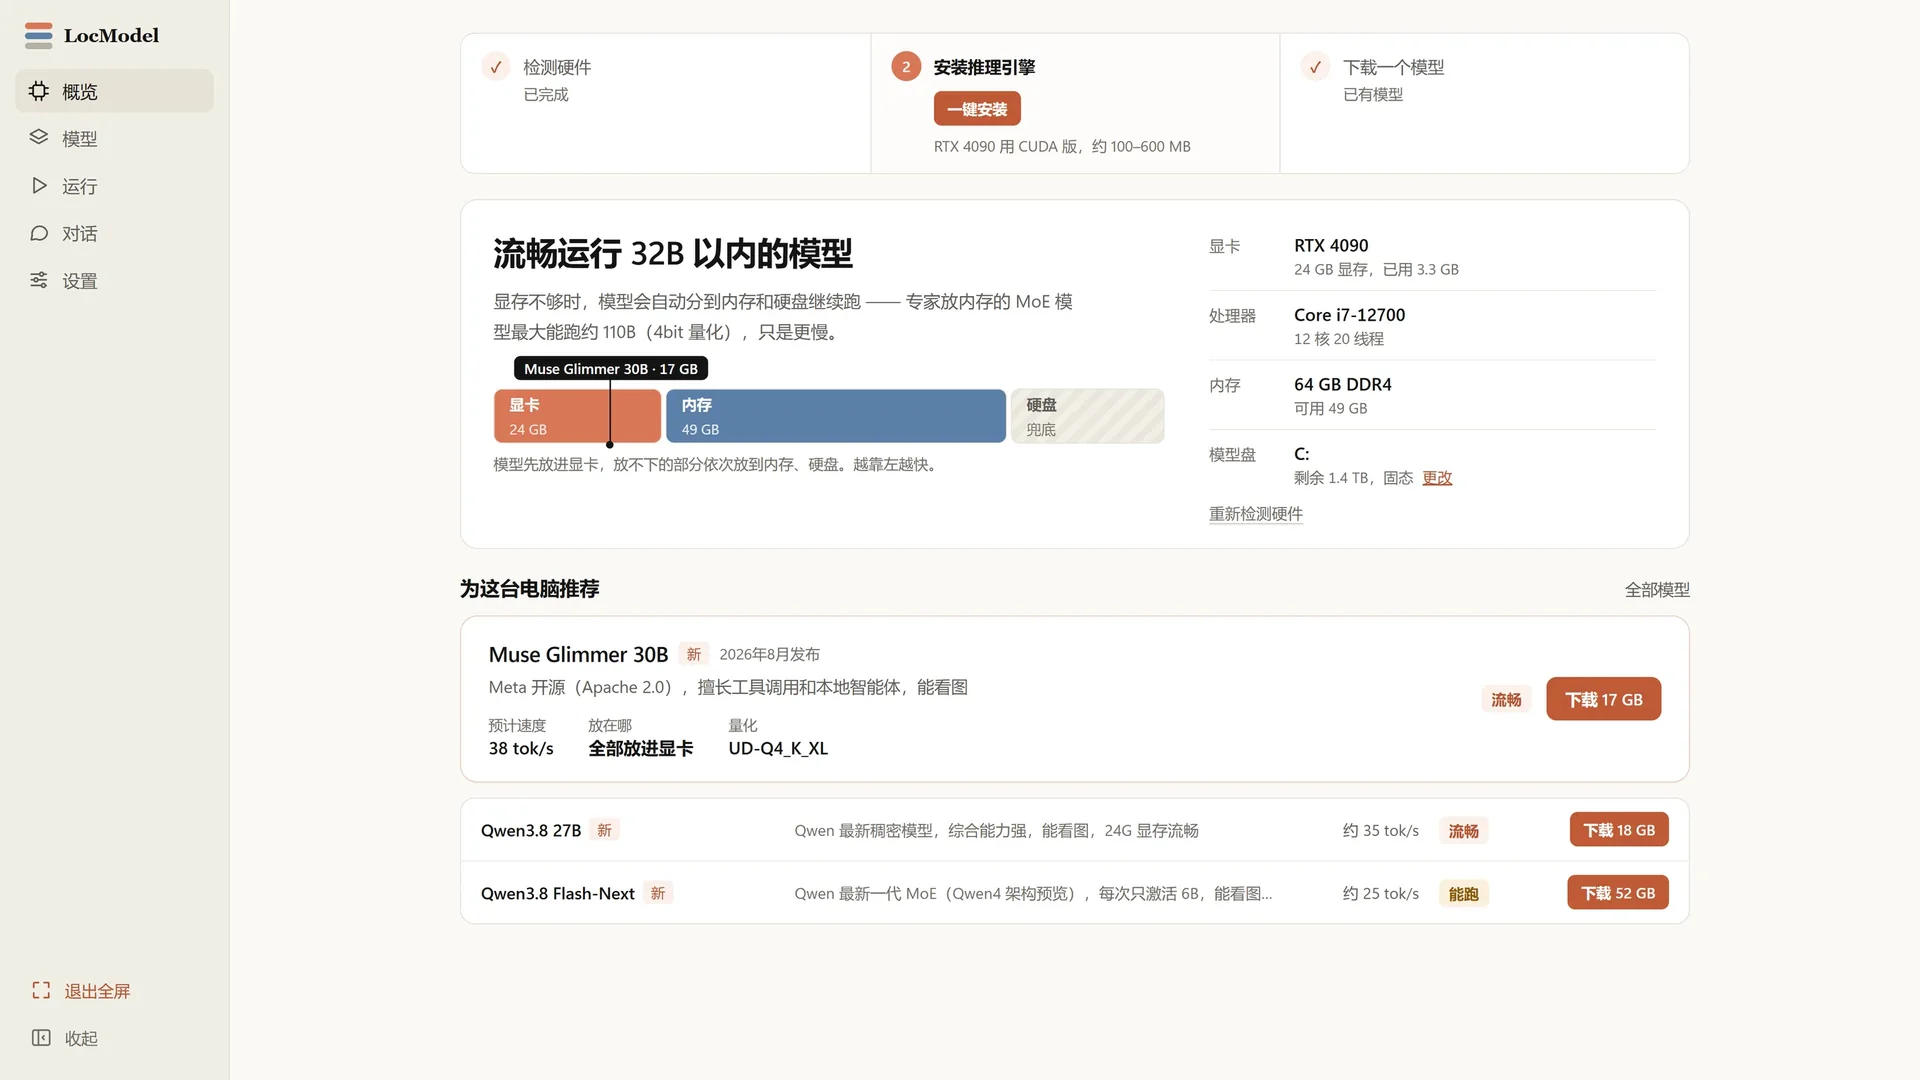
LocModel 概览:自动识别硬件并推荐可流畅运行的模型

01LocModel 3.1.0 · 概览

1键安装推理引擎
4种硬件后端
0云端依赖
100%本地运行

WHY LOCMODEL

本地部署,
不该这么难。

不用配环境,不用记参数。LocModel 把最麻烦的部分收起来,把模型留给你。现在,还多了一块画布、一段镜头,和一个能动手的 Agent。

01

自动识别硬件

显卡、处理器、内存、磁盘一次看清,直接告诉你哪些模型能跑、能跑多快。

02

一键推理引擎

自动匹配 llama.cpp 后端,NVIDIA、AMD、Intel 和纯 CPU 都照顾到,不用自己编译。

03

模型自由进出

在线下载 HuggingFace 模型,也能导入本地 GGUF。模型是你的,不锁在某个平台里。

04

显存智能分层

显存放不下时,自动把部分层放进内存和硬盘。大模型照样能跑,只是慢一点。

01 / HARDWARE

它先读懂
你的电脑。

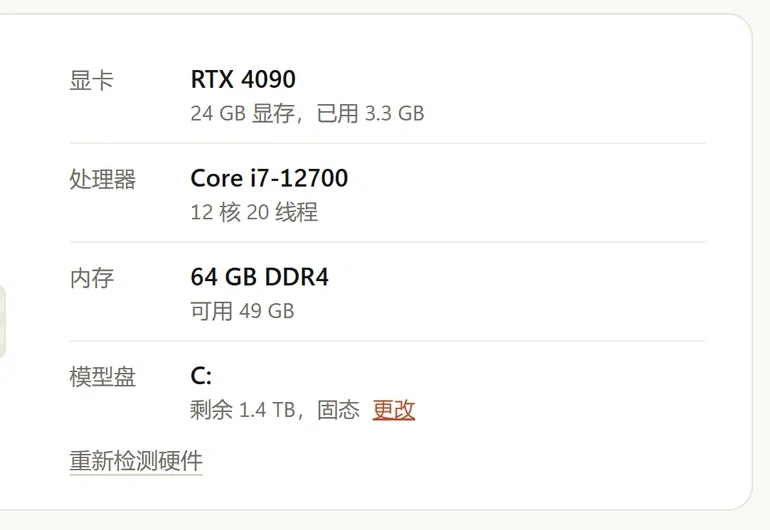
打开 LocModel,先看到的不是参数,而是一份硬件体检:显卡型号与显存、处理器核心、可用内存、模型盘空间。
  • 自动识别 NVIDIA / AMD / Intel / CPU
  • 按显存和内存推荐能流畅运行的模型
  • 启动前就能看到速度与首次加载时间
查看支持的硬件
这台电脑
LocModel 硬件检测:RTX 4090、Core i7-12700、64 GB DDR4 与模型盘信息
推荐
Muse Glimmer 30B 38 tok/s · 17 GB · 全部放进显卡
LocModel 一键安装推理引擎,自动识别显卡并显示下载进度
CUDAVulkanCPU

02 / ENGINE

推理引擎,
一键就位。

LocModel 会自动下载与你的显卡匹配的 llama.cpp 官方构建。网络不好,也可以手动导入 zip,进度、速度、剩余时间都看得见。

  • 自动识别 NVIDIA CUDA、AMD、Intel 与 CPU
  • 下载可暂停,失败可重试
  • 支持手动导入本地引擎,离线也能装

03 / MODELS

模型,
就在手边。

推荐模型、在线搜索、已安装管理放在同一页。每个模型都标好大小、量化方式、预计速度和适配程度。
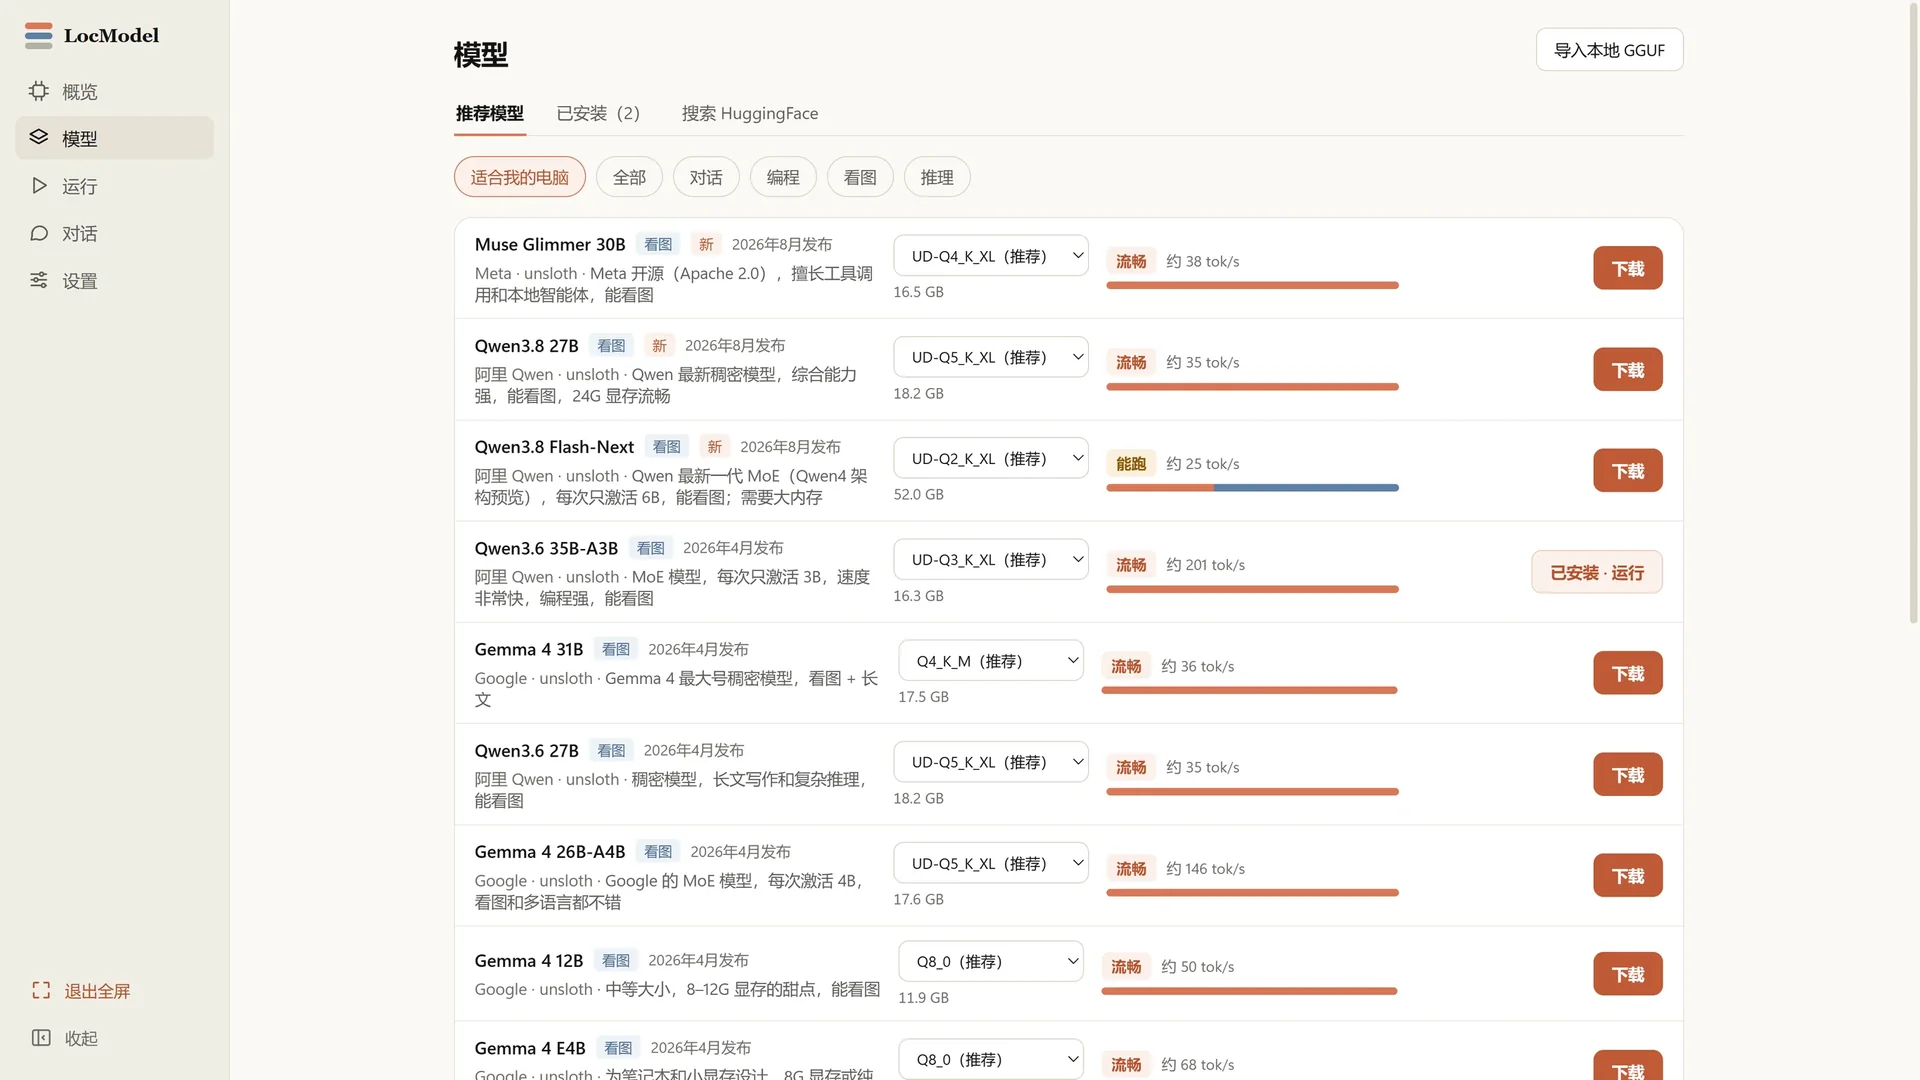
LocModel 模型库:推荐模型、在线下载、已安装模型与 HuggingFace 搜索
A

在线下载

按硬件与用途筛选 HuggingFace 模型,点一下就开始下载。

B

导入 GGUF

本地文件直接导入,不用转换格式,也不用上传到任何地方。

C

已安装管理

版本、大小、量化方式与运行状态,一页看完。

NEW / IMAGE

一句话,
出四张。

输入中文提示词,选好画幅、步数、张数和种子。Z-Image Turbo 在你的显卡上直接出图,不上传、不排队。
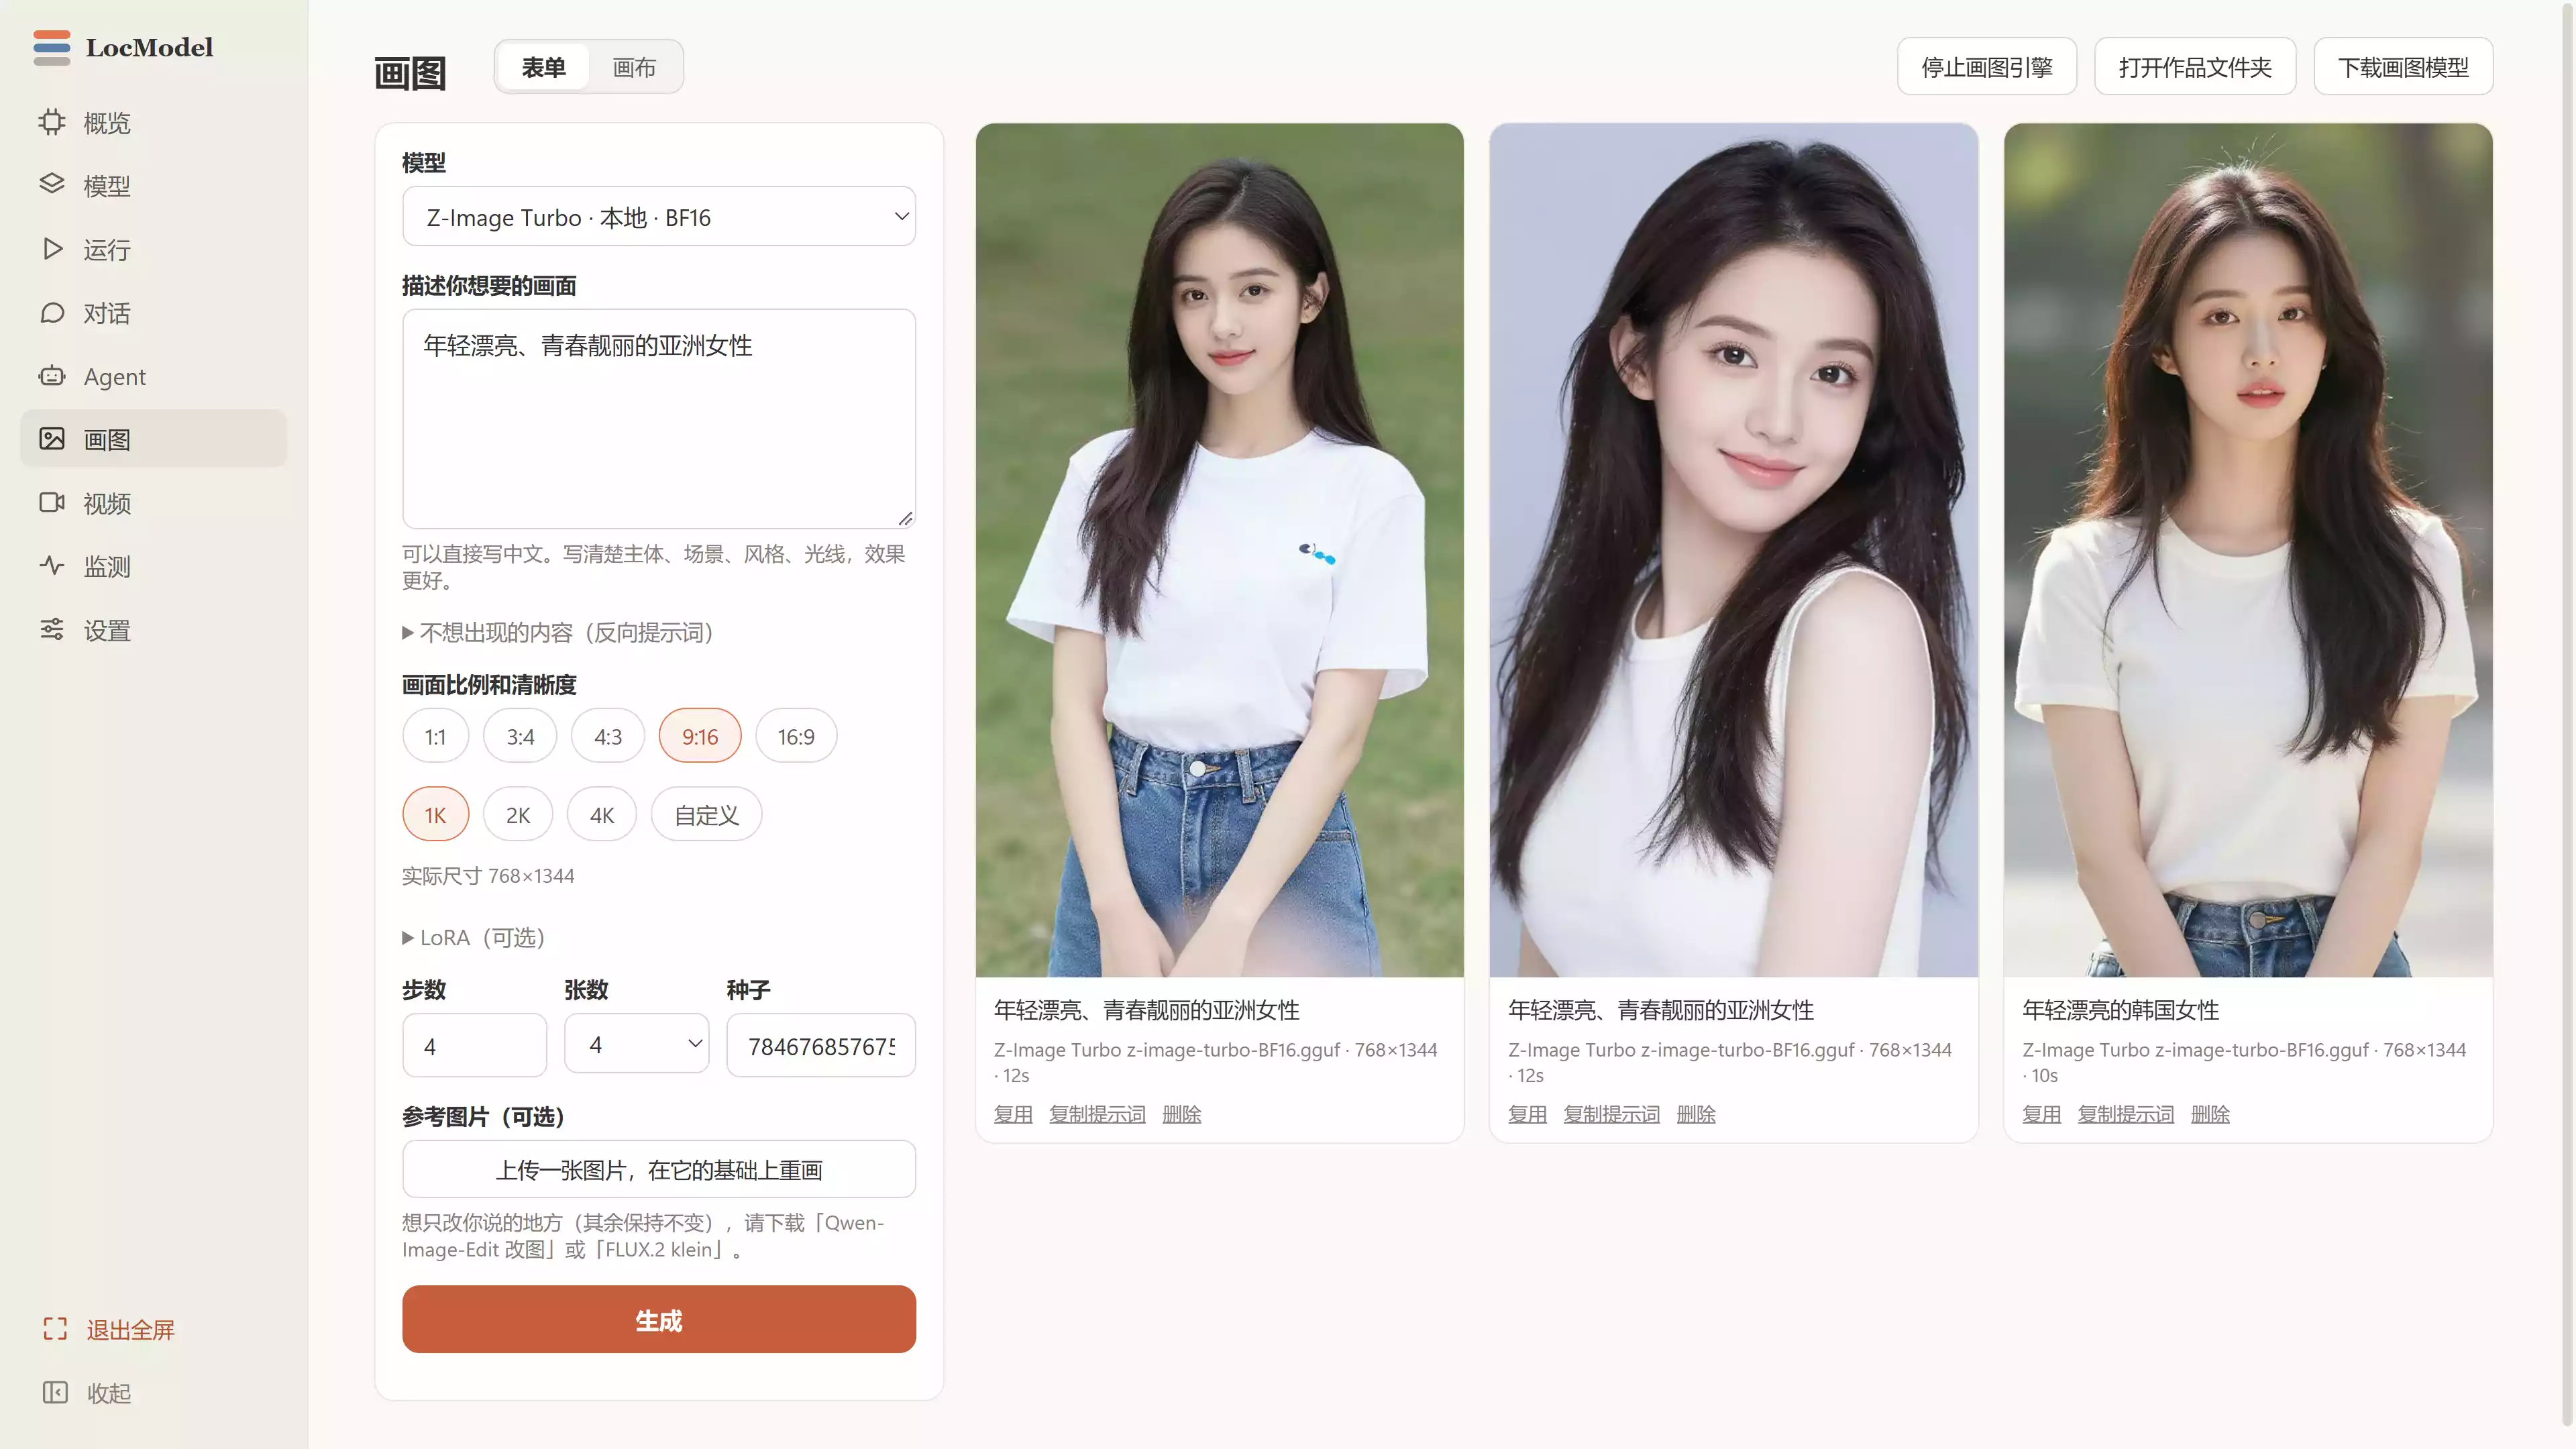
  • 主体、场景、风格与光线,都能用中文描述
  • 1:1、3:4、4:3、9:16、16:9 五种画幅
  • 步数、张数、种子可调,满意结果能复现
  • 支持参考图重绘,在原有画面上继续改
Z-Image TurboZ-Image EditFLUX.2 klein本地推理
LocModel 本地画图界面:中文提示词、画幅、步数、张数、种子与本地生成的人像

画图 · Z-Image Turbo · 768 × 1344 · 本地生成
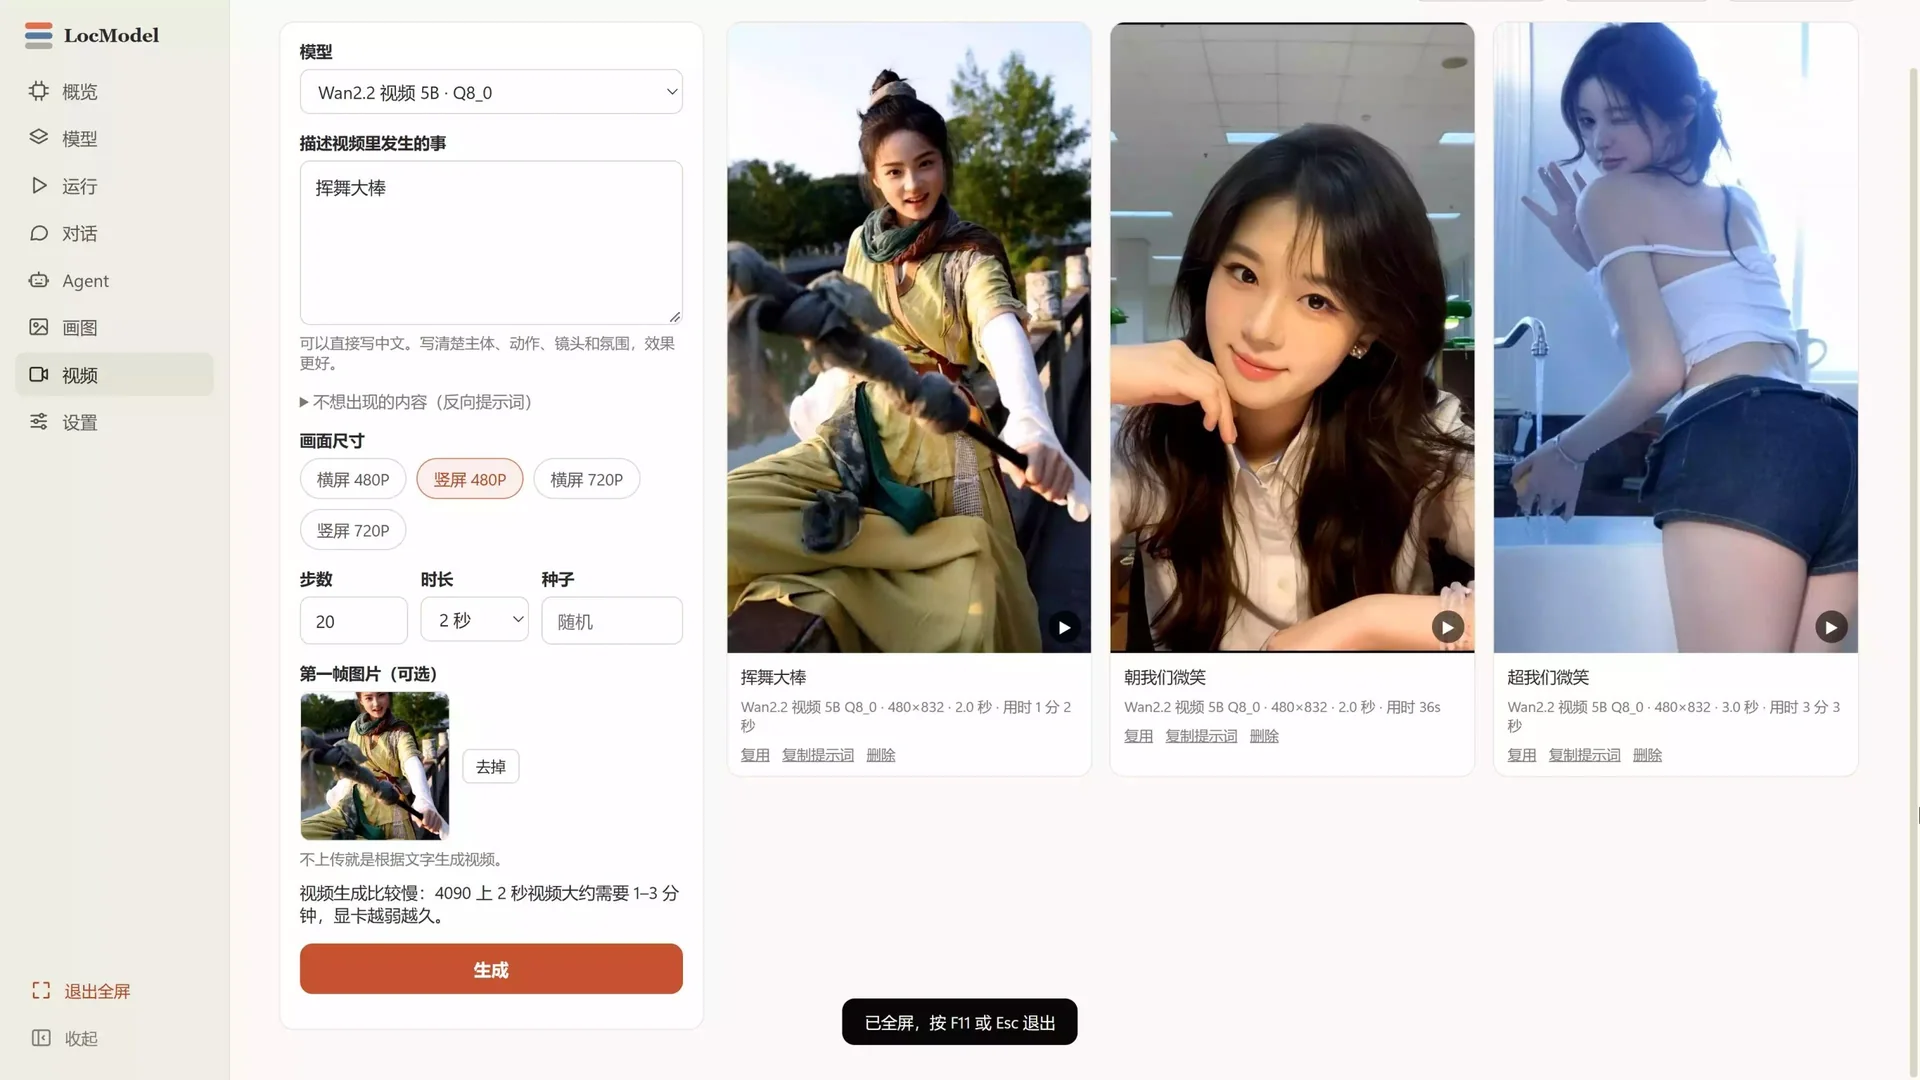
LocModel 本地视频生成界面:Wan2.2 模型、提示词、横竖屏尺寸、时长与竖版视频结果

视频 · Wan2.2 视频 5B · 竖屏 480P · 本地生成

NEW / VIDEO

让画面,
动起来。

写清主体、动作、镜头和氛围,Wan2.2 会把它变成一段短视频。也可以先放一张首帧图,让指定画面接着往下演。

  • 文字直接生成视频,或上传首帧图续写
  • 横屏 / 竖屏,480P 与 720P 可选
  • 时长、步数、种子与反向提示词都能调
  • 生成进度与耗时直接显示,不用盲等
Wan2.2 视频 5B文生视频图生视频竖屏 480P / 720P

04 / RUN

参数,
已经替你算好。

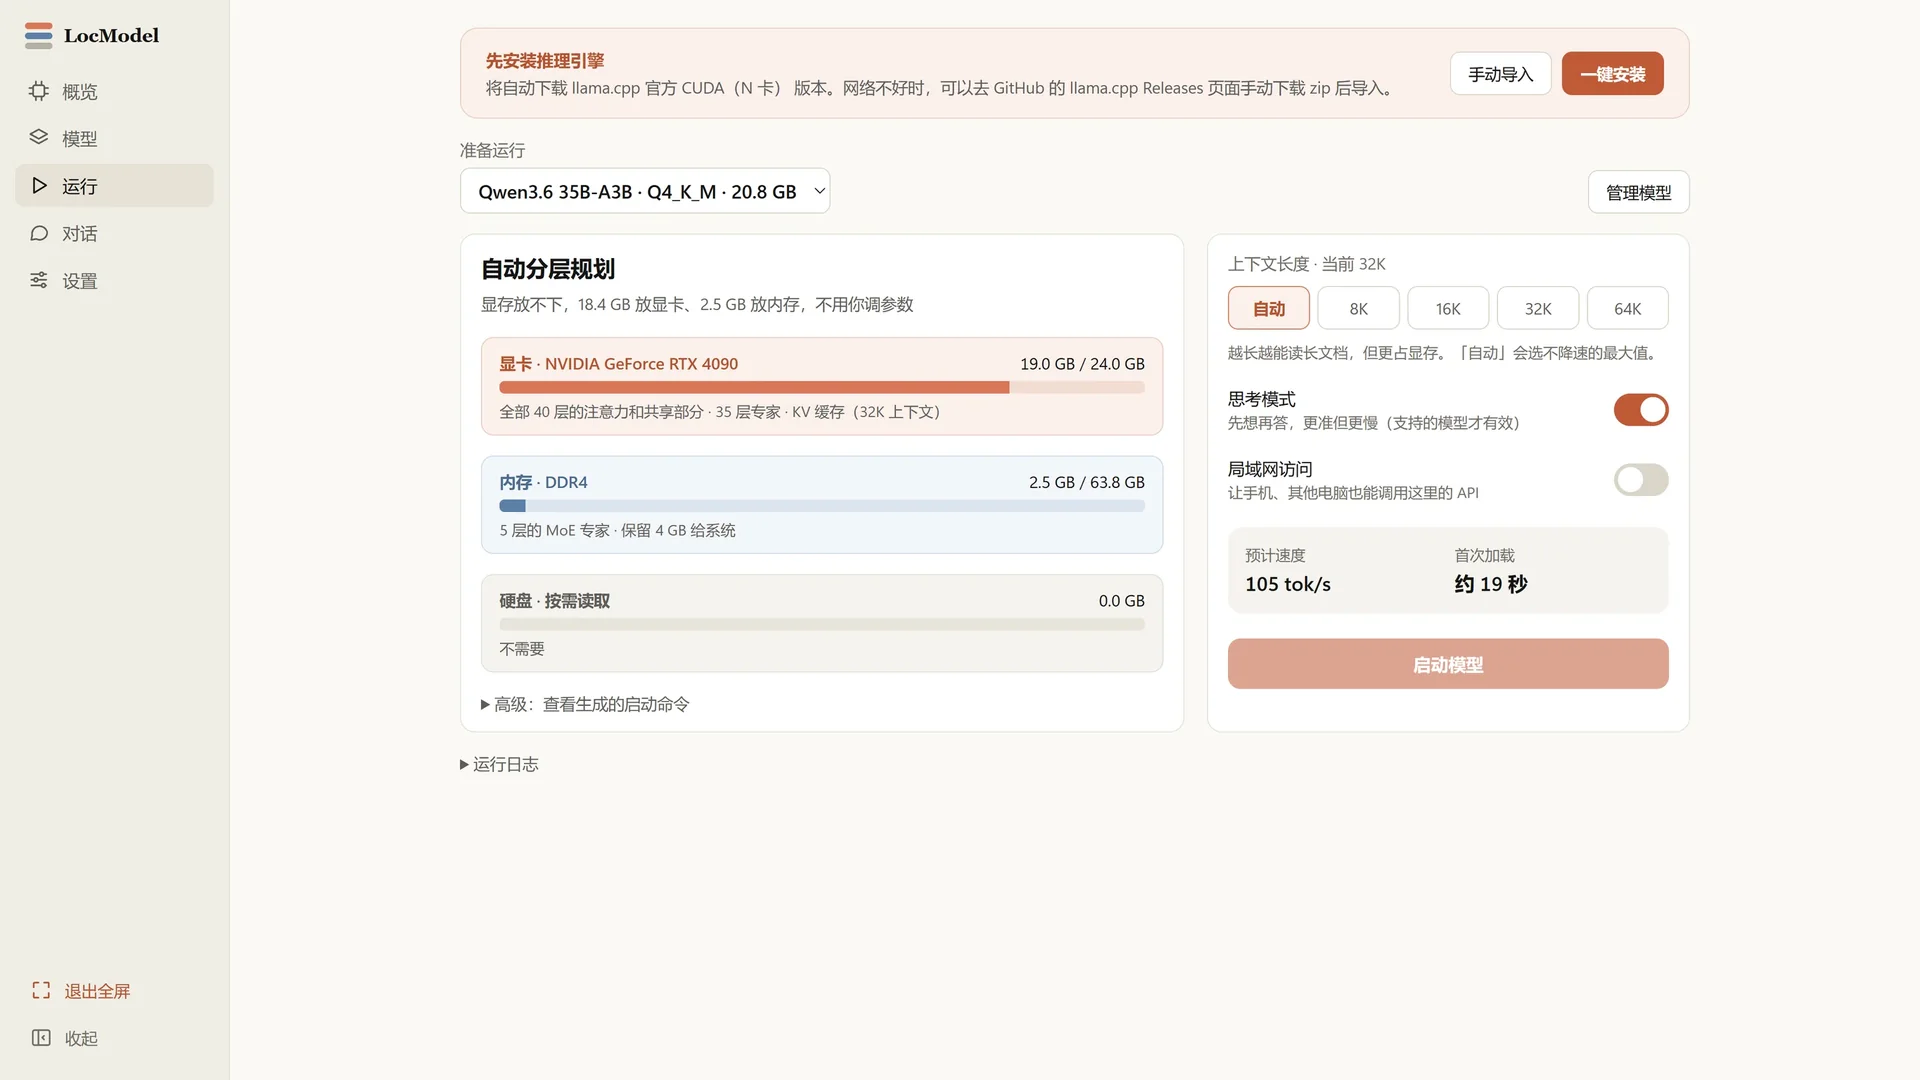
上下文长度、思考模式、局域网访问、预计速度——常用的选择都在手边,默认值已经足够好。
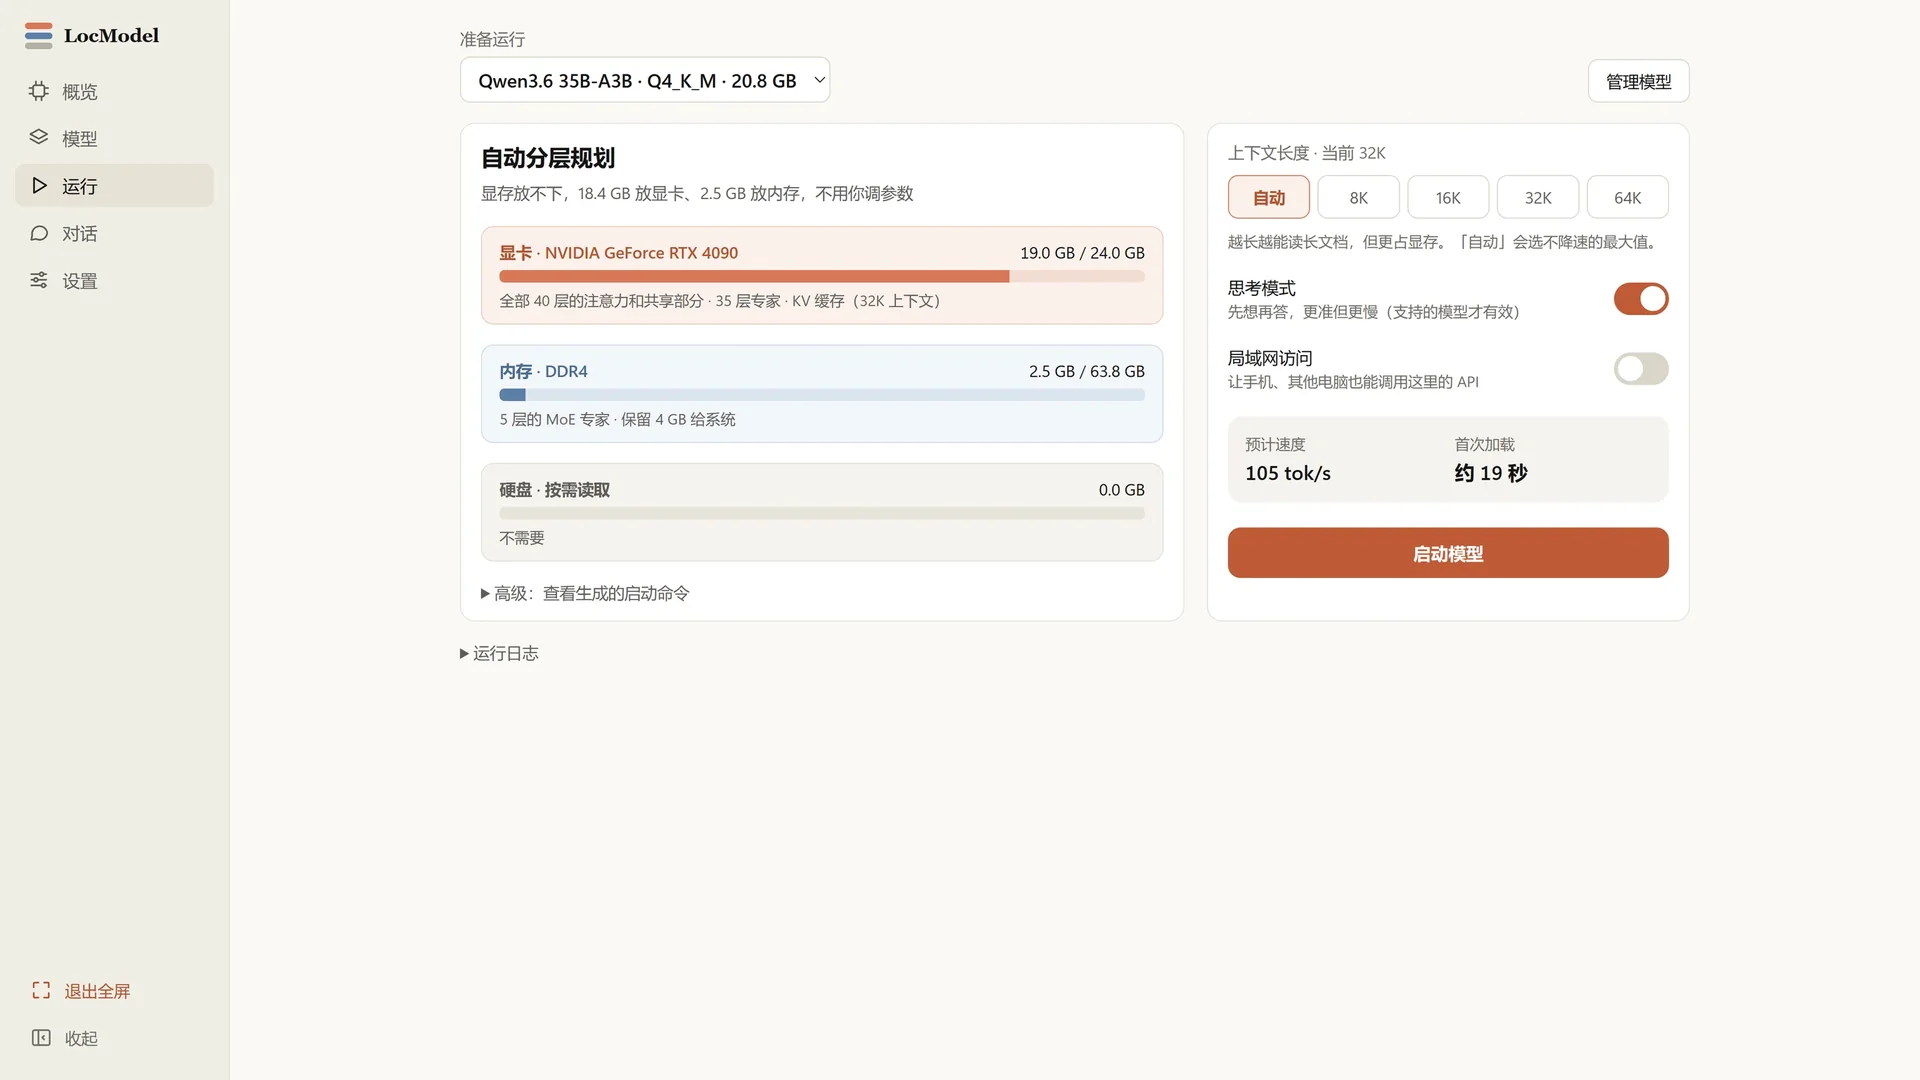
  • 8K / 16K / 32K / 64K 上下文一键切换
  • 思考模式,让模型先想再答
  • 局域网访问,手机和其他电脑也能调用
LocModel 启动模型:上下文长度、思考模式、局域网访问、预计速度与首次加载时间
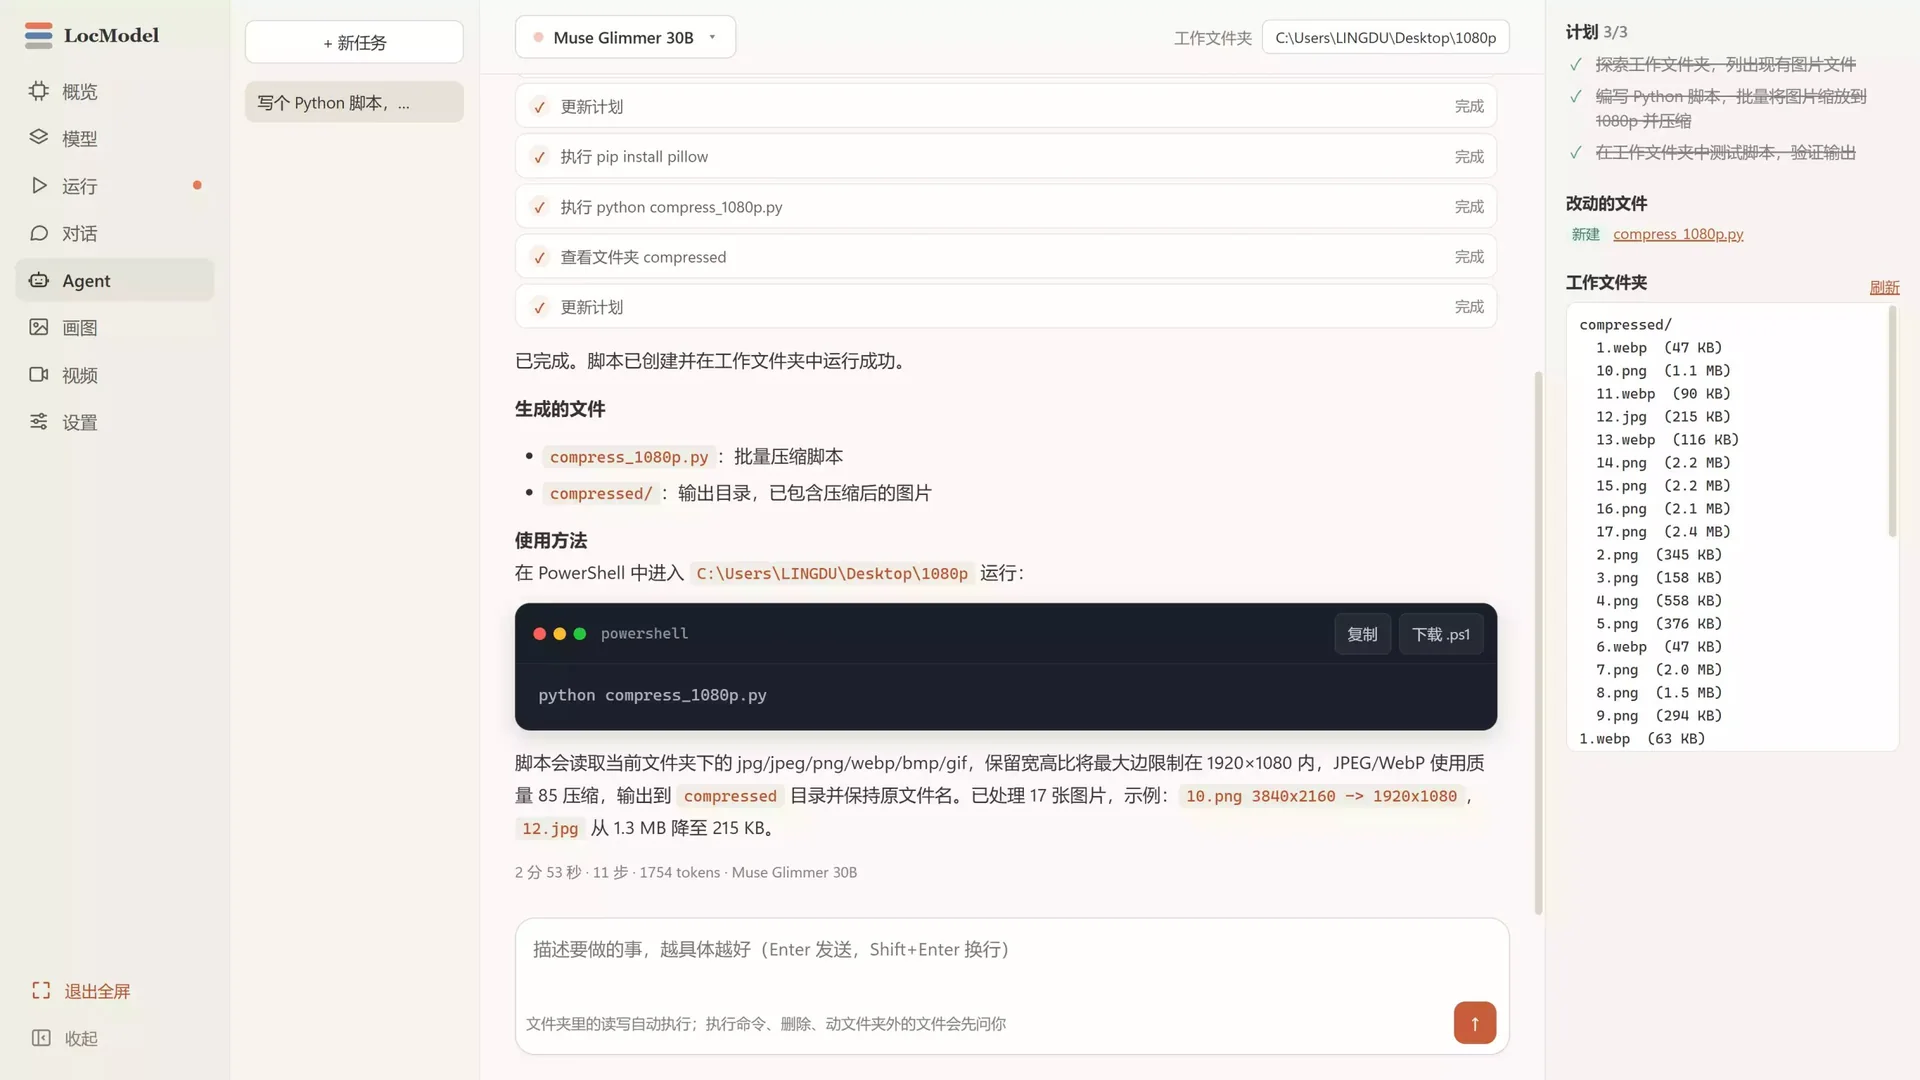
LocModel Agent 界面:任务计划、PowerShell 命令、生成文件与工作文件夹列表

Agent · Muse Glimmer 30B · 11 步 · 2 分 53 秒

NEW / AGENT

交代一句,
它自己动手。

指定一个工作文件夹,Agent 会拆解计划、读写文件、写脚本并执行命令。每一步都更新状态,完成后把结果列给你。

  • 自动生成计划,逐条执行并更新进度
  • 在文件夹内读写,运行 Python / PowerShell
  • 删除、移动或访问文件夹外内容前先询问
  • 完成后验证输出,不只回一句「应该可以」

文件夹内自动执行 · 文件夹外先问你

Muse Glimmer 30BAgent 本地调用文件读写命令执行

NEW / CHAT & CODE

聊得明白,
也写得出来。

从一个问题到一份能运行的脚本。本地模型能读懂附件、写代码、解释思路,代码块可以一键复制或下载。
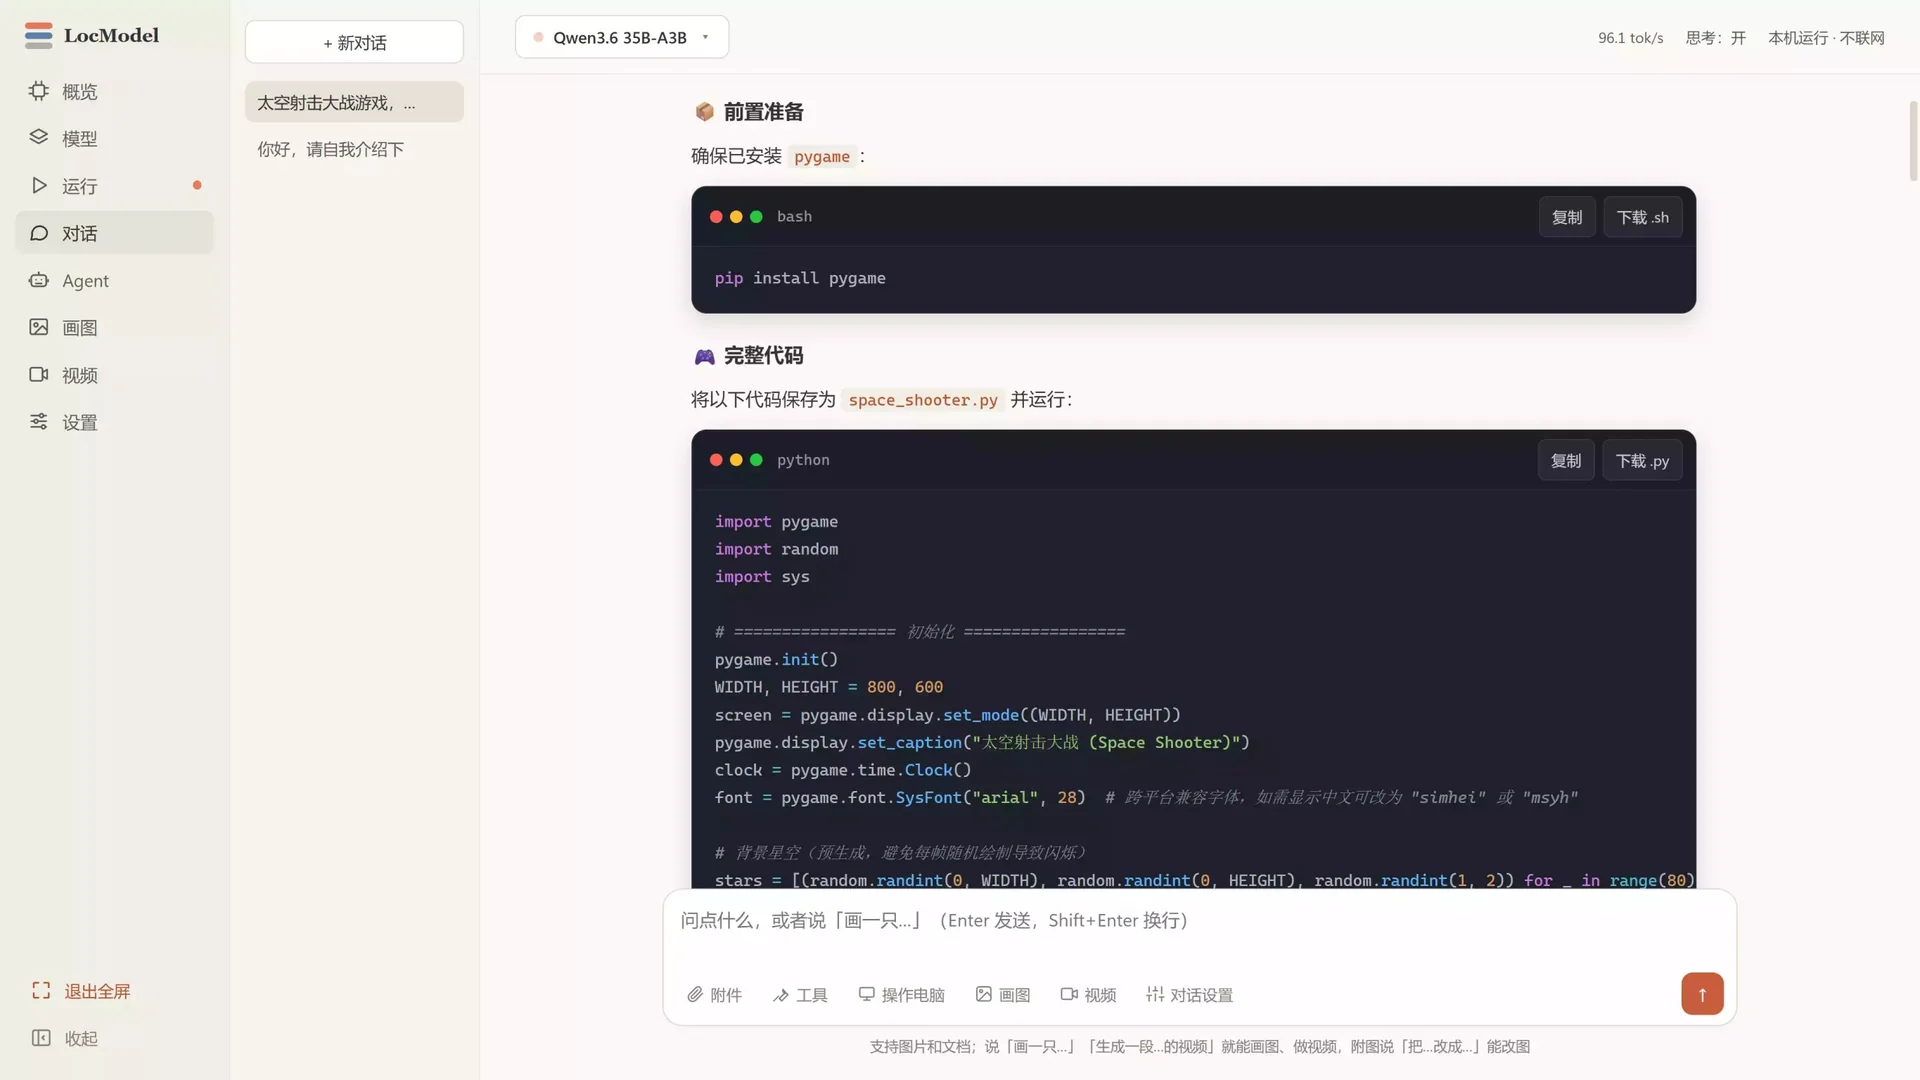
  • 多轮对话,支持附件、文档与长上下文
  • 代码块一键复制 / 下载 .py / .sh
  • 思考模式、tok/s 与上下文长度都看得见
  • 全程本机推理,断网也能继续
Qwen3.6 35B-A3B96.1 tok/s思考模式本地 · 不联网
LocModel 本地对话界面:Qwen3.6 生成 Pygame 太空射击游戏完整代码,代码块可复制和下载

对话与代码 · Qwen3.6 35B-A3B · 96.1 tok/s

05 / AUTO TIERING

显存不够,
也不会被卡住。

LocModel 会把注意力层、专家层和 KV 缓存按顺序放进显卡、内存和硬盘。越靠左越快,放不下的部分自动往后排。
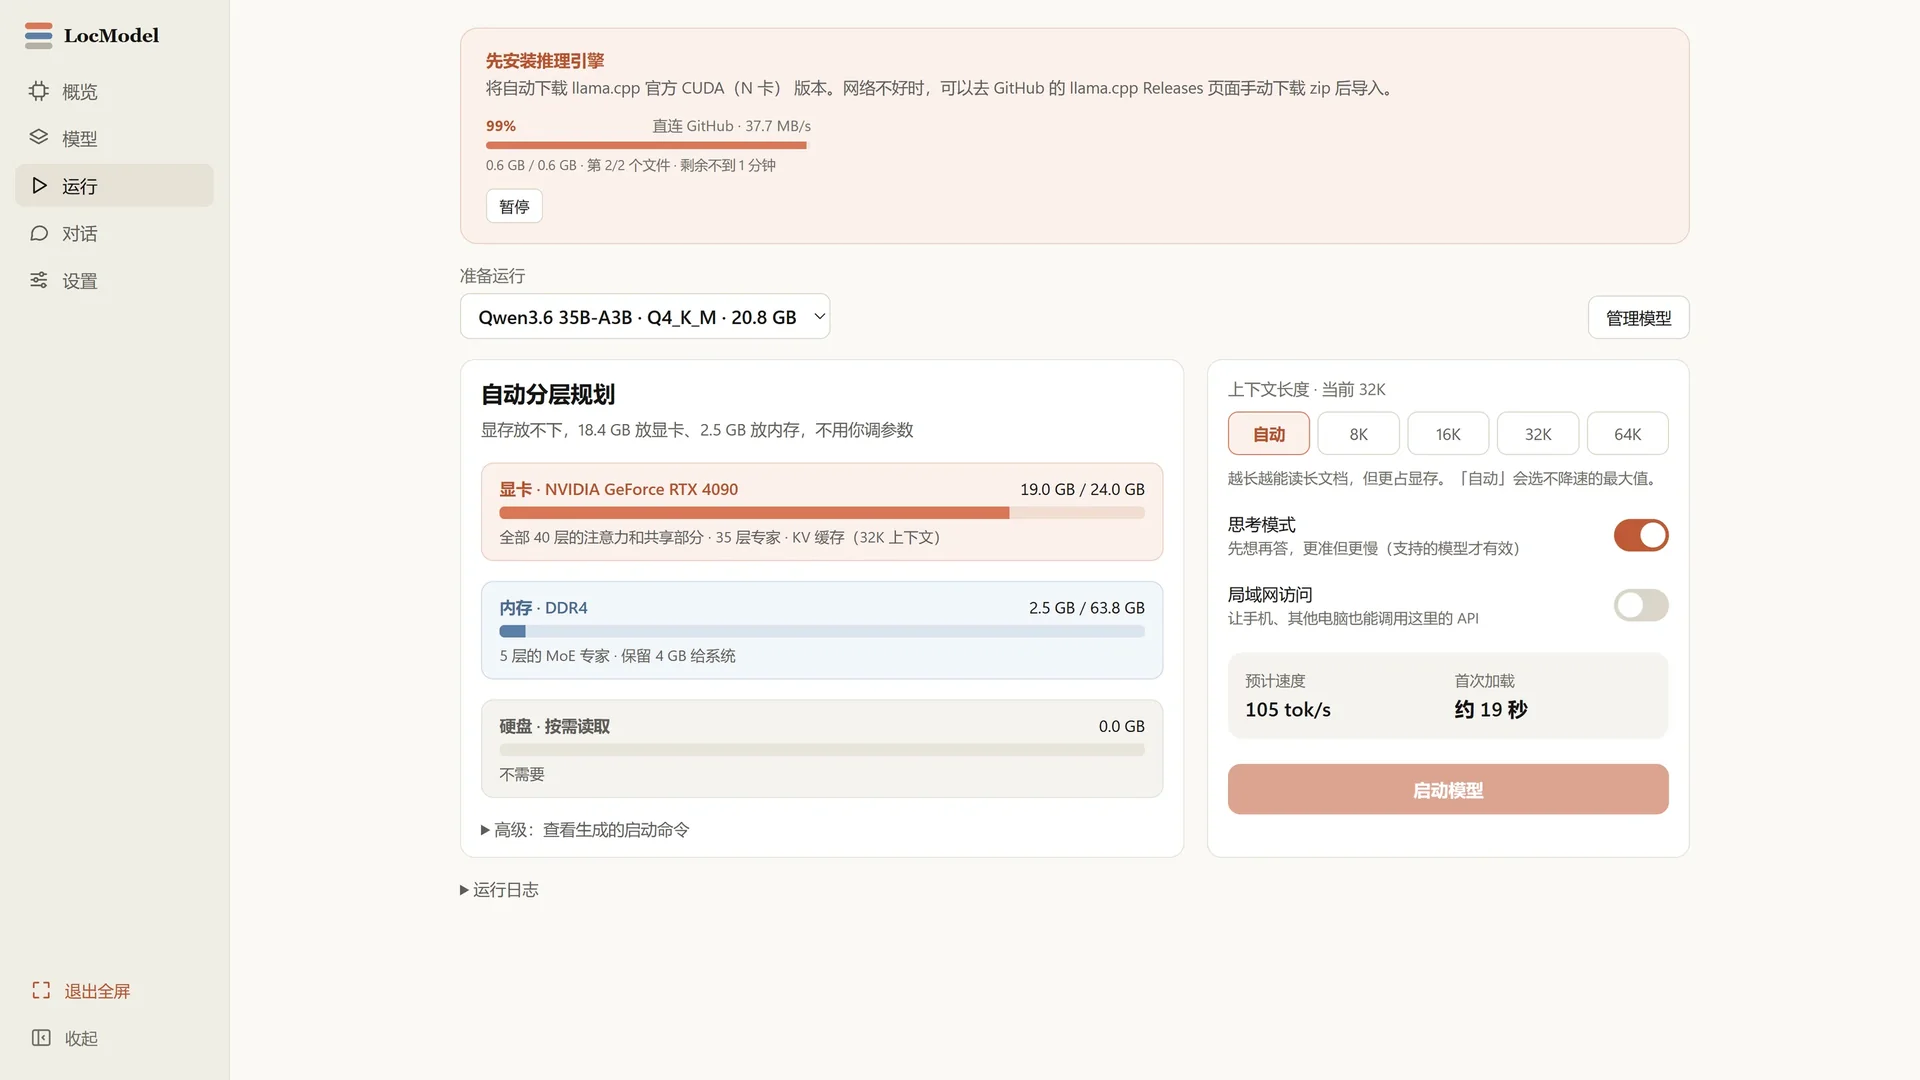
显卡 · RTX 409019.0 / 24.0 GB
注意力 / 共享部分 / KV 缓存
内存 · DDR42.5 / 63.8 GB
5 层 MoE 专家 · 保留 4 GB 给系统
硬盘 · 按需读取0.0 GB
放不下时才会用到,容量换速度
LocModel 自动分层规划:显卡、内存与硬盘的显存分配,以及推理引擎下载进度

不需要调参数。LocModel 会自己算。

HOW IT WORKS

三步,
从零到跑起来。

不需要命令行,不需要读一堆文档。打开 LocModel,跟着界面走就行。

01

检测硬件

自动读取显卡、处理器、内存与磁盘,生成一份能跑什么模型的清单。

02

安装引擎

匹配你的显卡,下载对应的推理后端。进度可见,随时可以暂停。

03

下载并启动

选一个模型,或在本地导入 GGUF。点下启动,开始本地推理;也可以直接画图、生成视频,或把任务交给 Agent。

COMPATIBILITY

从 CPU 到 RTX 5090,
都有位置。

NVIDIA CUDA AMD Intel CPU Windows 10/11 x64 GGUF HuggingFace Z-Image Wan2.2 Agent

LOCAL BY DEFAULT

模型在本地,
数据不出门。

没有账号,没有云端排队,没有用量限制。下载、导入、运行,全在这台电脑上完成。现在,画图、视频生成和 Agent 执行也一样。

  • 无需登录,打开就能用
  • 提示词、参考图与生成的图片视频不离开本机
  • 离线也能推理、画图、生成视频和执行 Agent

DOWNLOAD

把 LocModel
装进你的电脑。

Windows 10/11 x64 · 免费 · 双击安装,是 LocModel 的主力平台。macOS 与 Linux 版本也已提供。

LocModel_3.1.0_x64-setup.exe v3.1.0

OTHER PLATFORMS

Windows 为主平台 · macOS / Linux 同步提供
macOS 版 NEW Universal · Apple 芯片与 Intel Mac
下载 .dmg
Linux 版 NEW x64 · 下载后解压运行
下载 .zip
macOS 首次安装提示

目前还未上证书。下载后右键 →「打开」就能用。如果无法安装,在终端执行:

sudo xattr -rd com.apple.quarantine /Applications/LocModel.app