本地大模型 · 一鍵部署v3.1.0

把大模型,
請進你的電腦。

LocModel 自動看懂你的硬體,推薦合適的開源模型,裝好推理引擎。線上下載或匯入 GGUF,點一下,就在本地跑起來。現在,它也學會了畫圖、生成影片和替你動手。

Windows 10/11 · x64·NVIDIA / AMD / Intel / CPU·資料留在本地

NEW 本地畫圖、影片生成與 Agent 本地執行已加入 檢視新能力
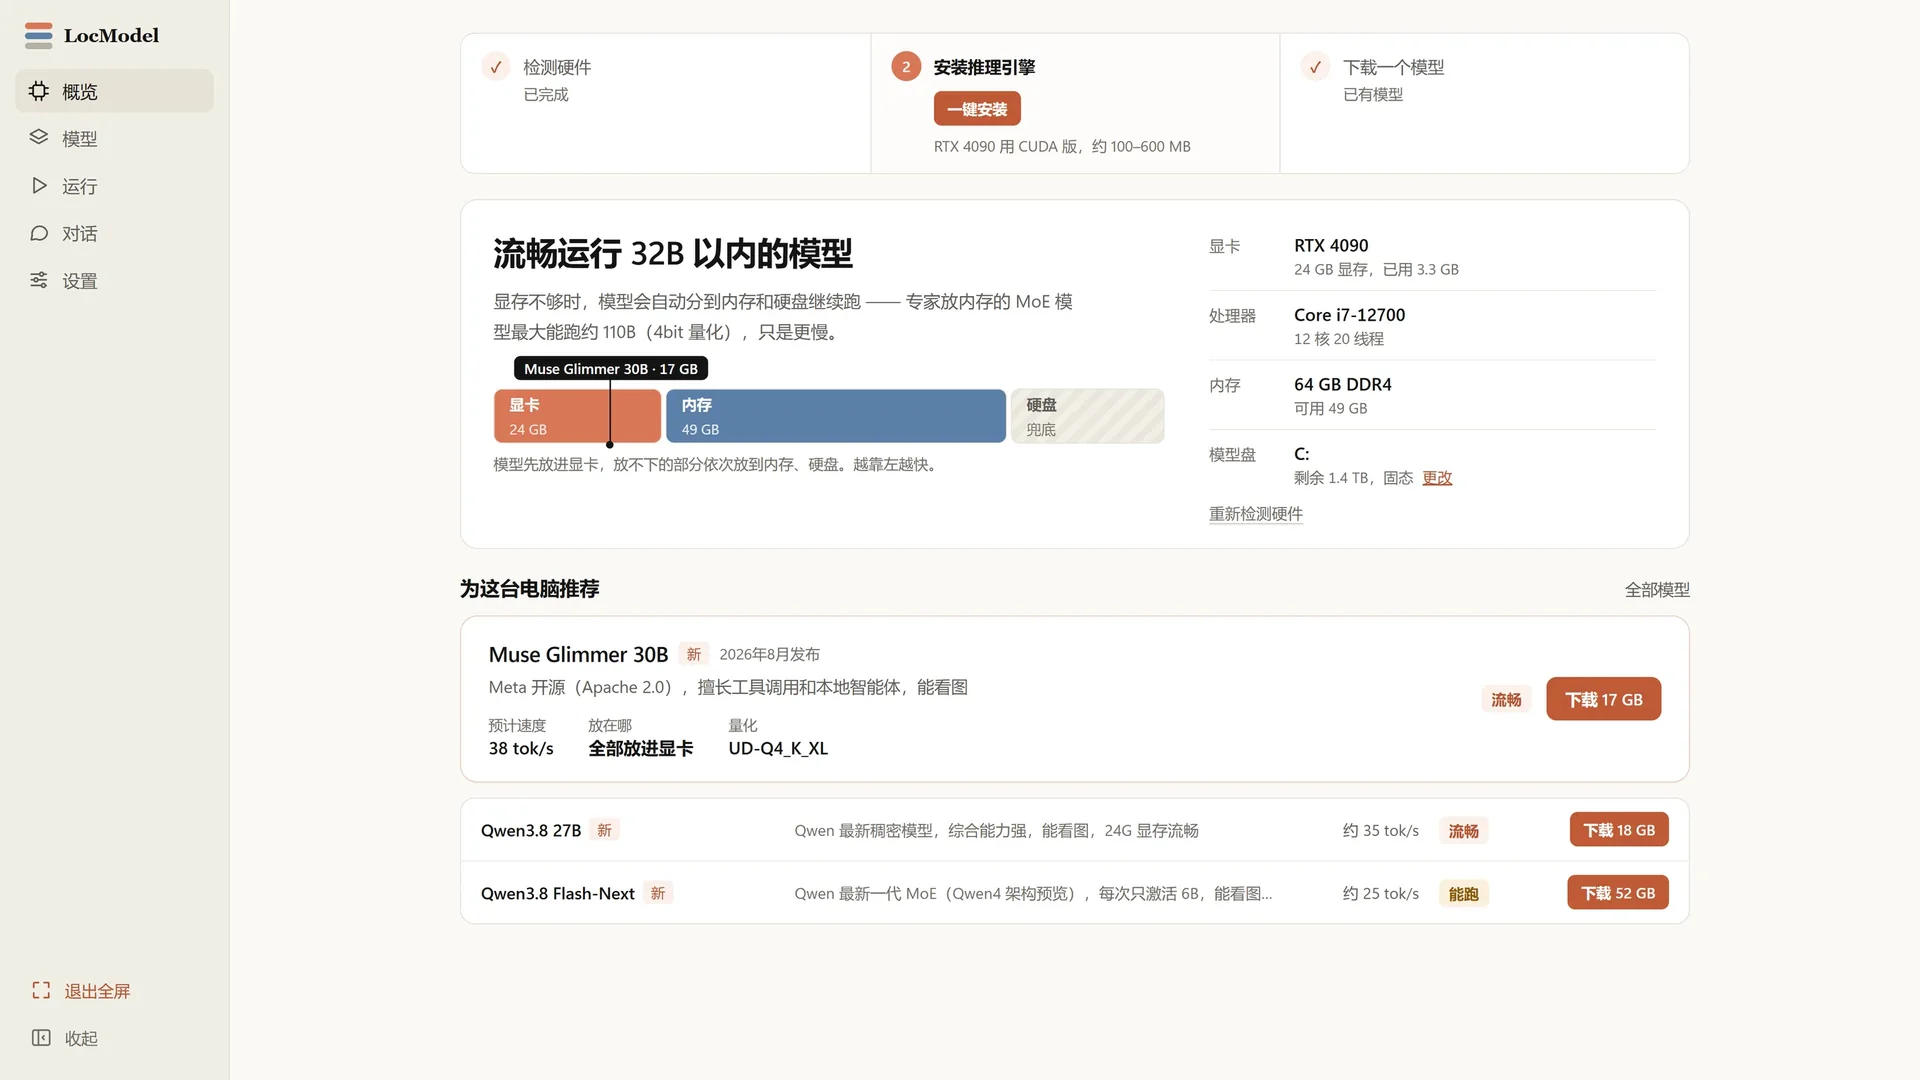
LocModel 概覽:自動識別硬體並推薦可流暢執行的模型

01LocModel 3.1.0 · 概覽

1鍵安裝推理引擎
4種硬體後端
0雲端依賴
100%本地執行

WHY LOCMODEL

本地部署,
不該這麼難。

不用配環境,不用記引數。LocModel 把最麻煩的部分收起來,把模型留給你。現在,還多了一塊畫布、一段鏡頭,和一個能動手的 Agent。

01

自動識別硬體

顯示卡、處理器、記憶體、磁碟一次看清,直接告訴你哪些模型能跑、能跑多快。

02

一鍵推理引擎

自動匹配 llama.cpp 後端,NVIDIA、AMD、Intel 和純 CPU 都照顧到,不用自己編譯。

03

模型自由進出

線上下載 HuggingFace 模型,也能匯入本地 GGUF。模型是你的,不鎖在某個平臺裡。

04

VRAM 智慧分層

視訊記憶體放不下時,自動把部分層放進記憶體和硬碟。大模型照樣能跑,只是慢一點。

01 / HARDWARE

它先讀懂
你的電腦。

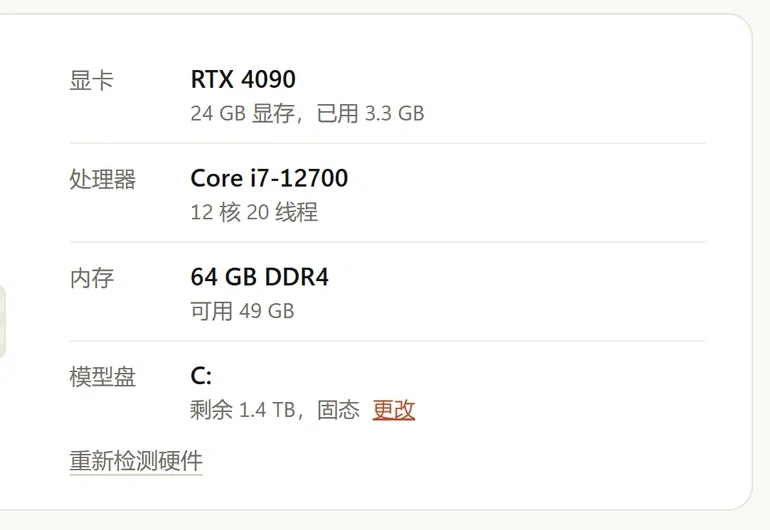
開啟 LocModel,先看到的不是引數,而是一份硬體體檢:顯示卡型號與視訊記憶體、處理器核心、可用記憶體、模型盤空間。
  • 自動識別 NVIDIA / AMD / Intel / CPU
  • 按視訊記憶體和記憶體推薦能流暢執行的模型
  • 啟動前就能看到速度與首次載入時間
檢視支援的硬體
這臺電腦
LocModel 硬體檢測:RTX 4090、Core i7-12700、64 GB DDR4 與模型盤資訊
推薦
Muse Glimmer 30B 38 tok/s · 17 GB · 全部放進顯示卡
LocModel 一鍵安裝推理引擎,自動識別顯示卡並顯示下載進度
CUDAVulkanCPU

02 / ENGINE

推理引擎,
一鍵就位。

LocModel 會自動下載與你的顯示卡匹配的 llama.cpp 官方構建。網路不好,也可以手動匯入 zip,進度、速度、剩餘時間都看得見。

  • 自動識別 NVIDIA CUDA、AMD、Intel 與 CPU
  • 下載可暫停,失敗可重試
  • 支援手動匯入本地引擎,離線也能裝

03 / MODELS

模型,
就在手邊。

推薦模型、線上搜尋、已安裝管理放在同一頁。每個模型都標好大小、量化方式、預計速度和適配程度。
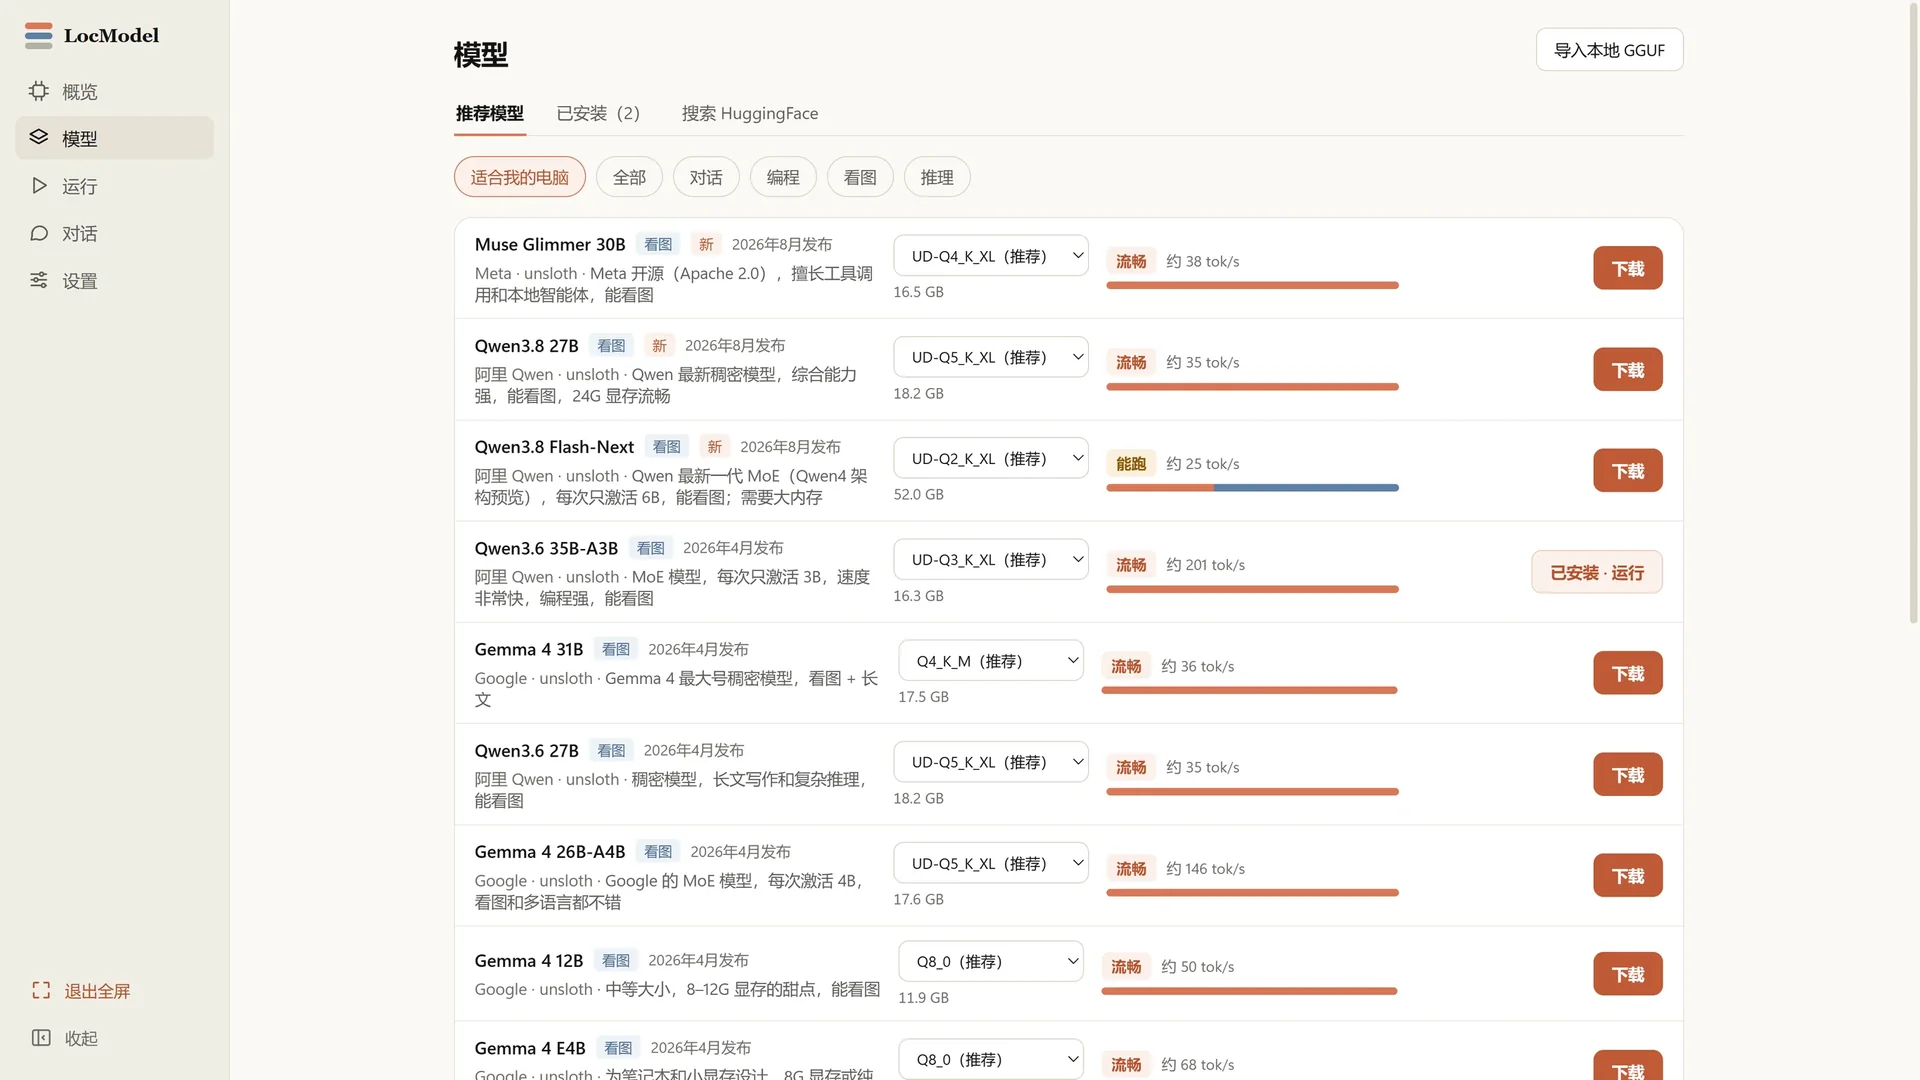
LocModel 模型庫:推薦模型、線上下載、已安裝模型與 HuggingFace 搜尋
A

線上下載

按硬體與用途篩選 HuggingFace 模型,點一下就開始下載。

B

匯入 GGUF

本地檔案直接匯入,不用轉換格式,也不用上傳到任何地方。

C

已安裝管理

版本、大小、量化方式與執行狀態,一頁看完。

NEW / IMAGE

一句話,
出四張。

輸入中文提示詞,選好畫幅、步數、張數和種子。Z-Image Turbo 在你的顯示卡上直接出圖,不上傳、不排隊。
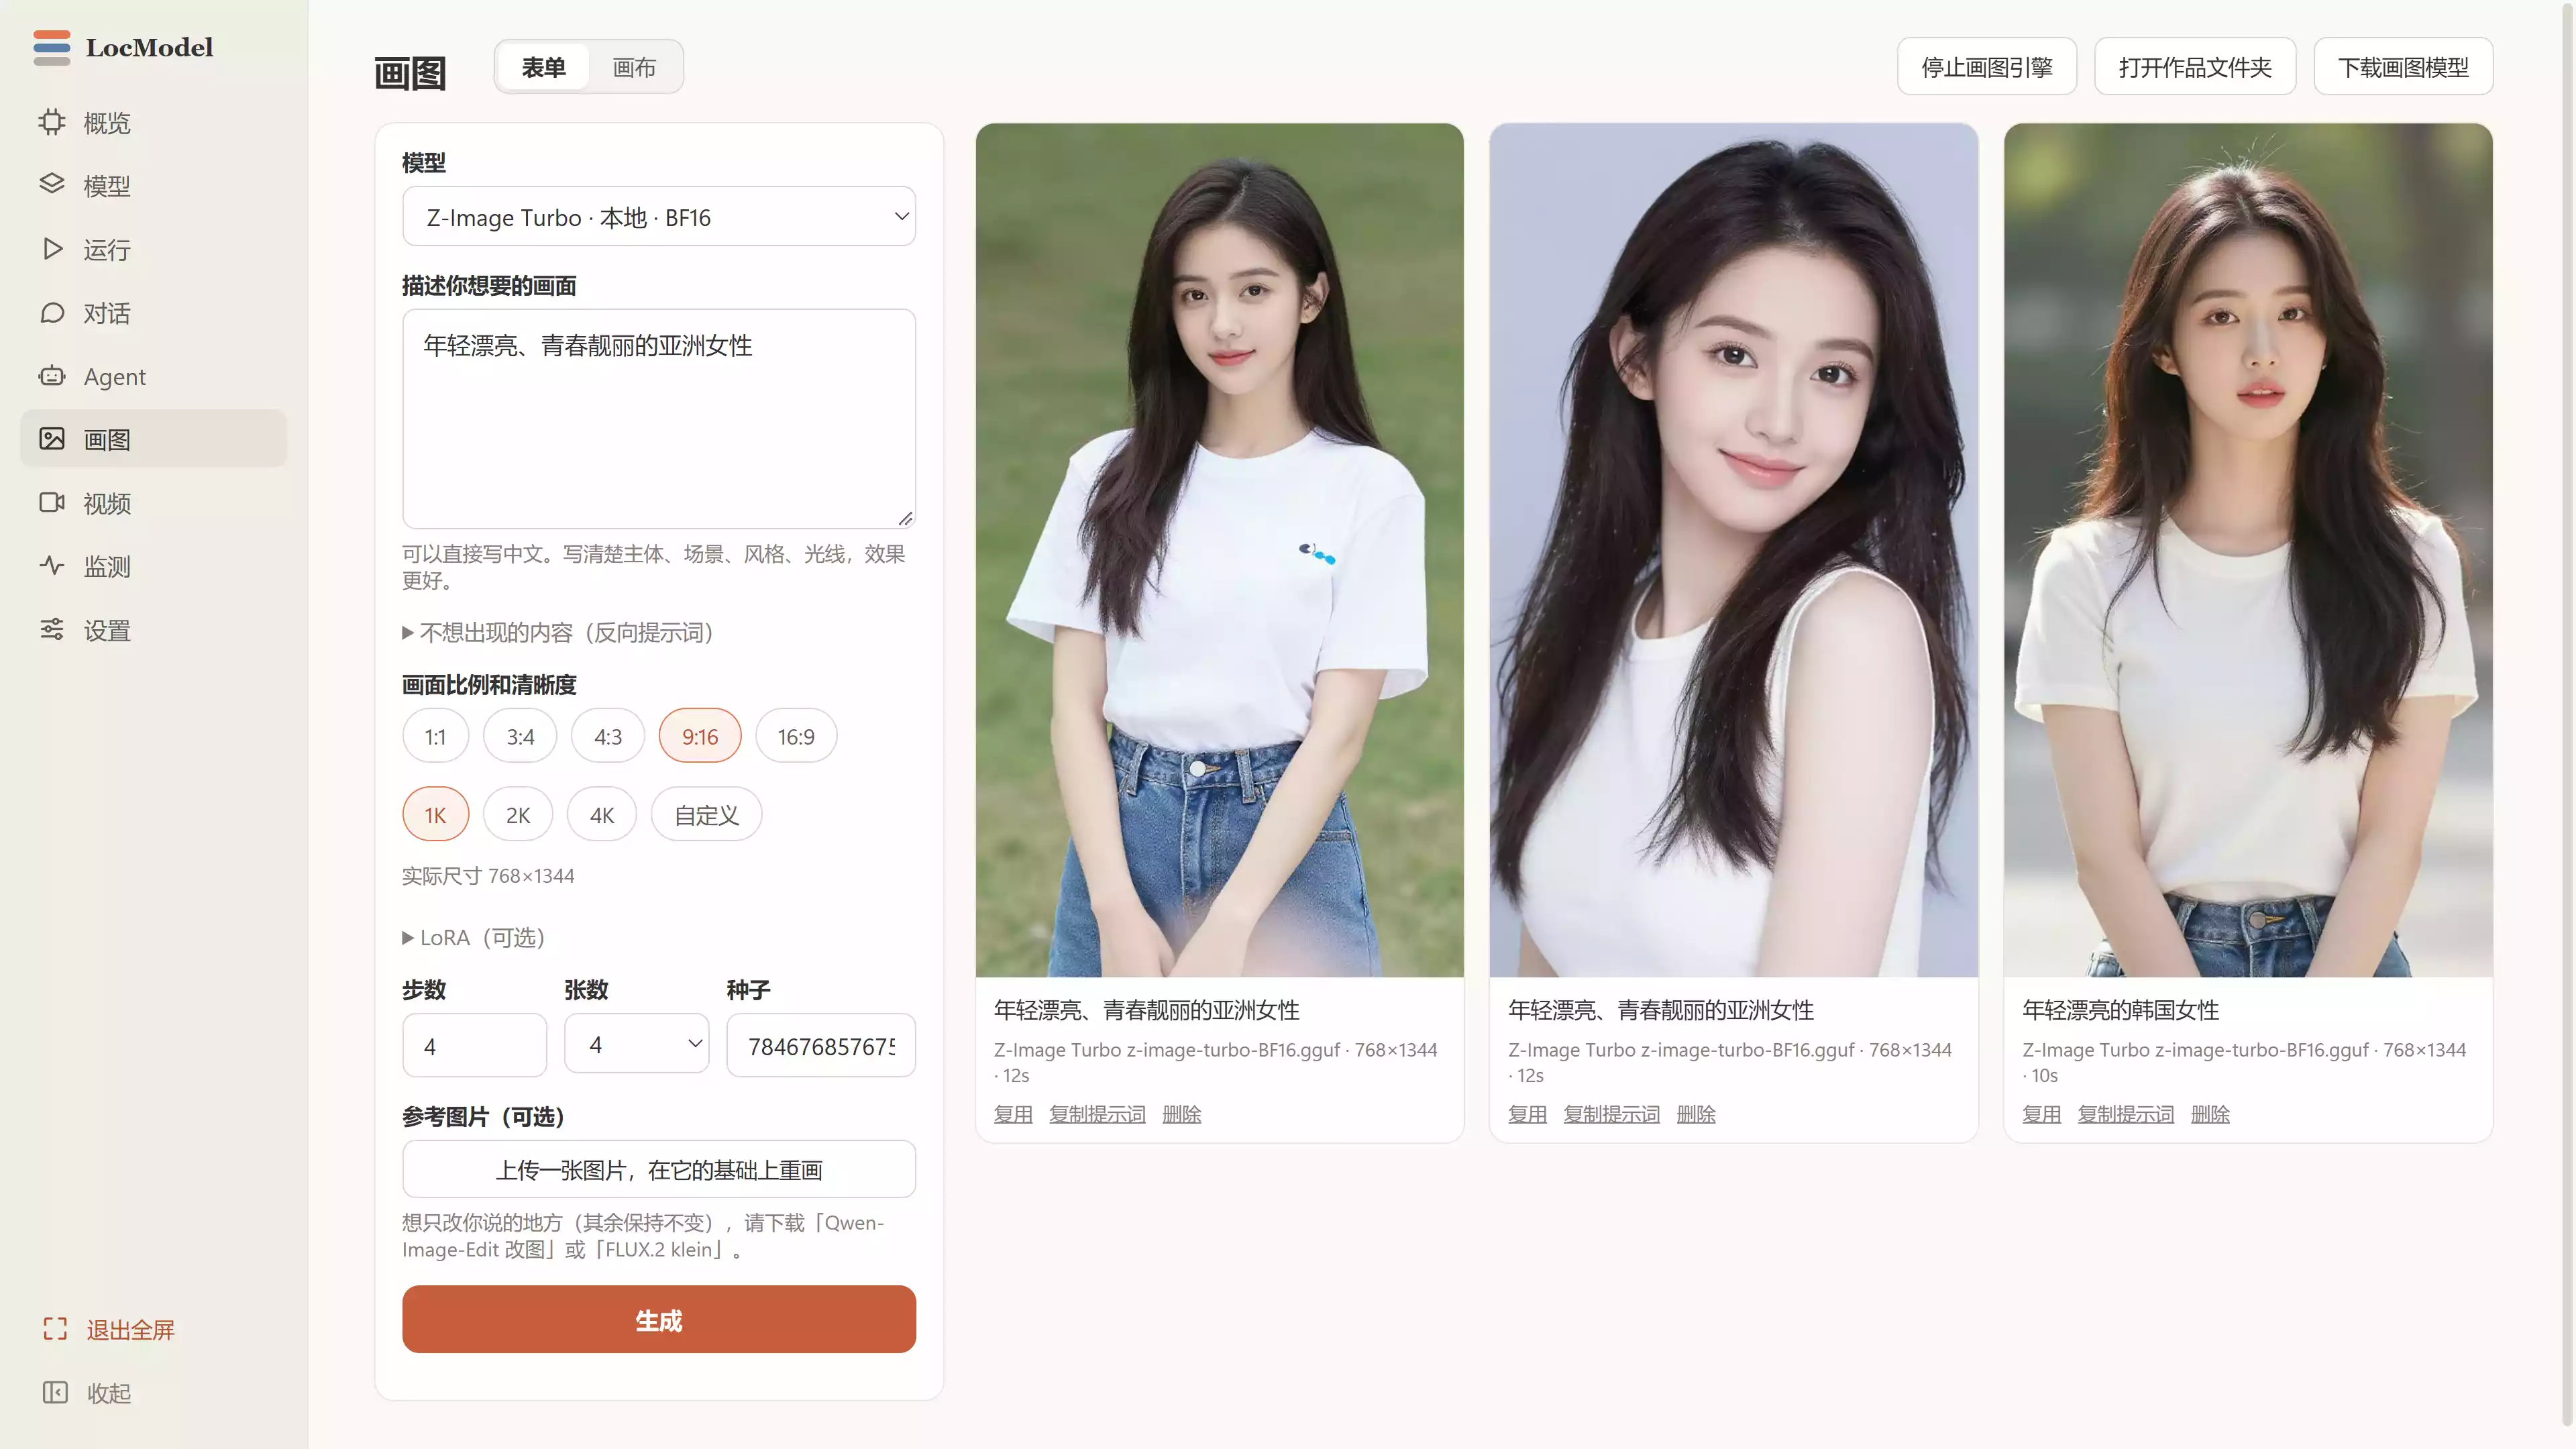
  • 主體、場景、風格與光線,都能用中文描述
  • 1:1、3:4、4:3、9:16、16:9 五種畫幅
  • 步數、張數、種子可調,滿意結果能復現
  • 支援參考圖重繪,在原有畫面上繼續改
Z-Image TurboZ-Image EditFLUX.2 klein本地推理
LocModel 本地畫圖介面:中文提示詞、畫幅、步數、張數、種子與本地生成的人像

畫圖 · Z-Image Turbo · 768 × 1344 · 本地生成
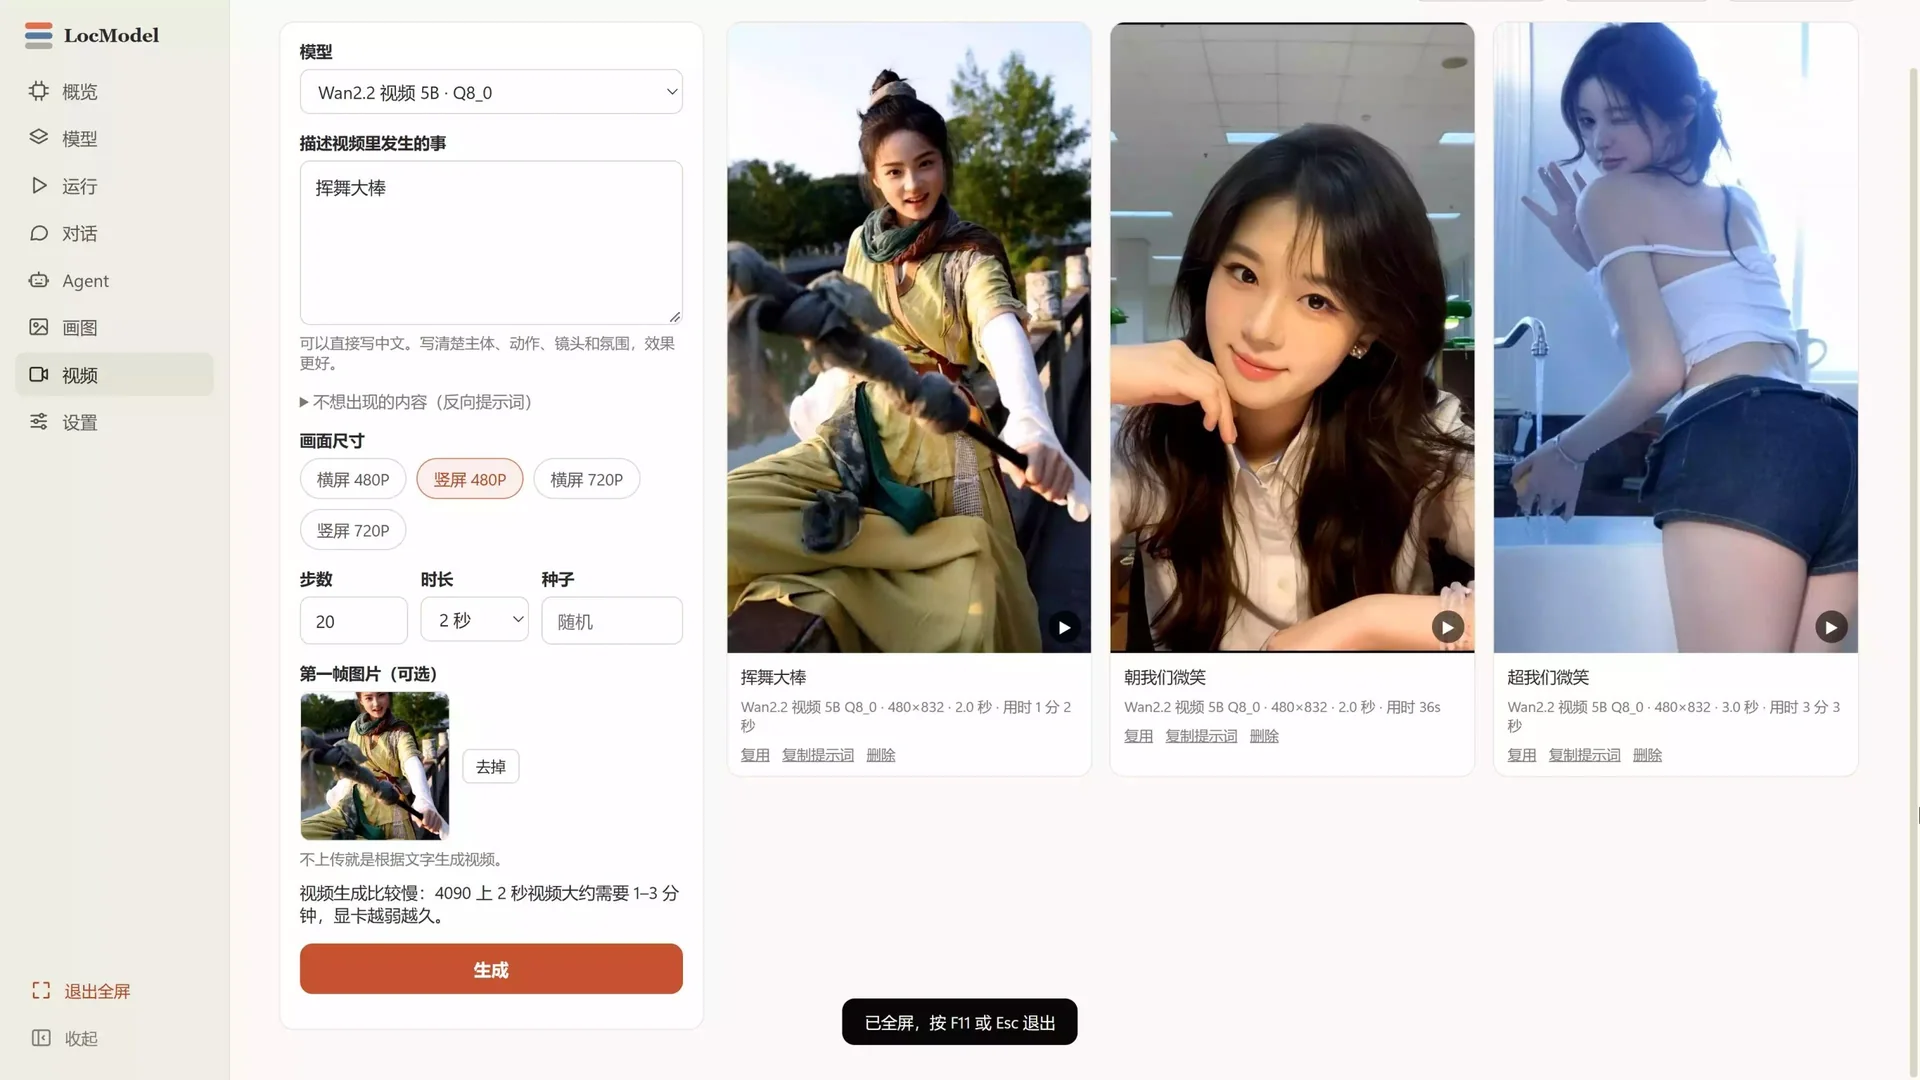
LocModel 本地影片生成介面:Wan2.2 模型、提示詞、橫豎屏尺寸、時長與豎版影片結果

影片 · Wan2.2 影片 5B · 豎屏 480P · 本地生成

NEW / VIDEO

讓畫面,
動起來。

寫清主體、動作、鏡頭和氛圍,Wan2.2 會把它變成一段短影片。也可以先放一張首幀圖,讓指定畫面接著往下演。

  • 文字直接生成影片,或上傳首幀圖續寫
  • 橫屏 / 豎屏,480P 與 720P 可選
  • 時長、步數、種子與反向提示詞都能調
  • 生成進度與耗時直接顯示,不用盲等
Wan2.2 影片 5B文生影片圖生影片豎屏 480P / 720P

04 / RUN

參數,
已經替你算好。

上下文長度、思考模式、區域網訪問、預計速度——常用的選擇都在手邊,預設值已經足夠好。
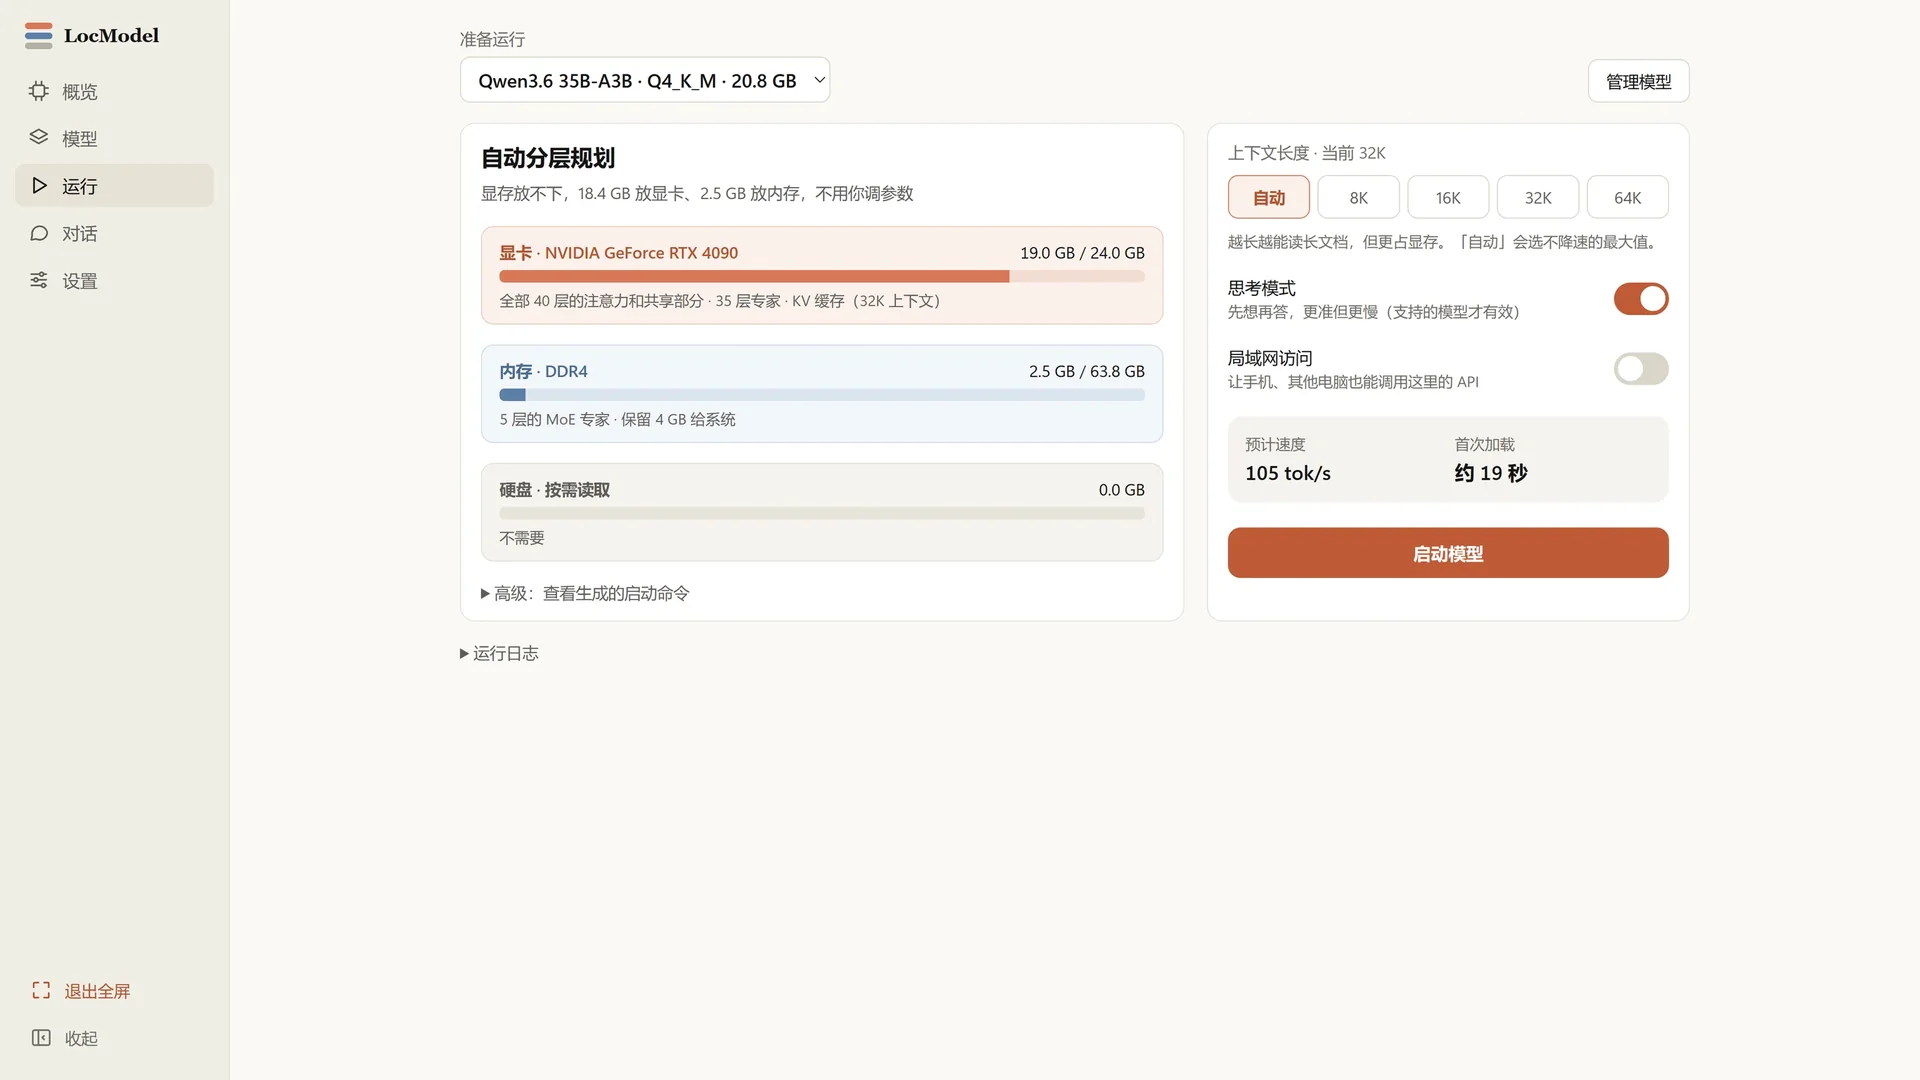
  • 8K / 16K / 32K / 64K 上下文一鍵切換
  • 思考模式,讓模型先想再答
  • 區域網訪問,手機和其他電腦也能呼叫
LocModel 啟動模型:上下文長度、思考模式、區域網訪問、預計速度與首次載入時間
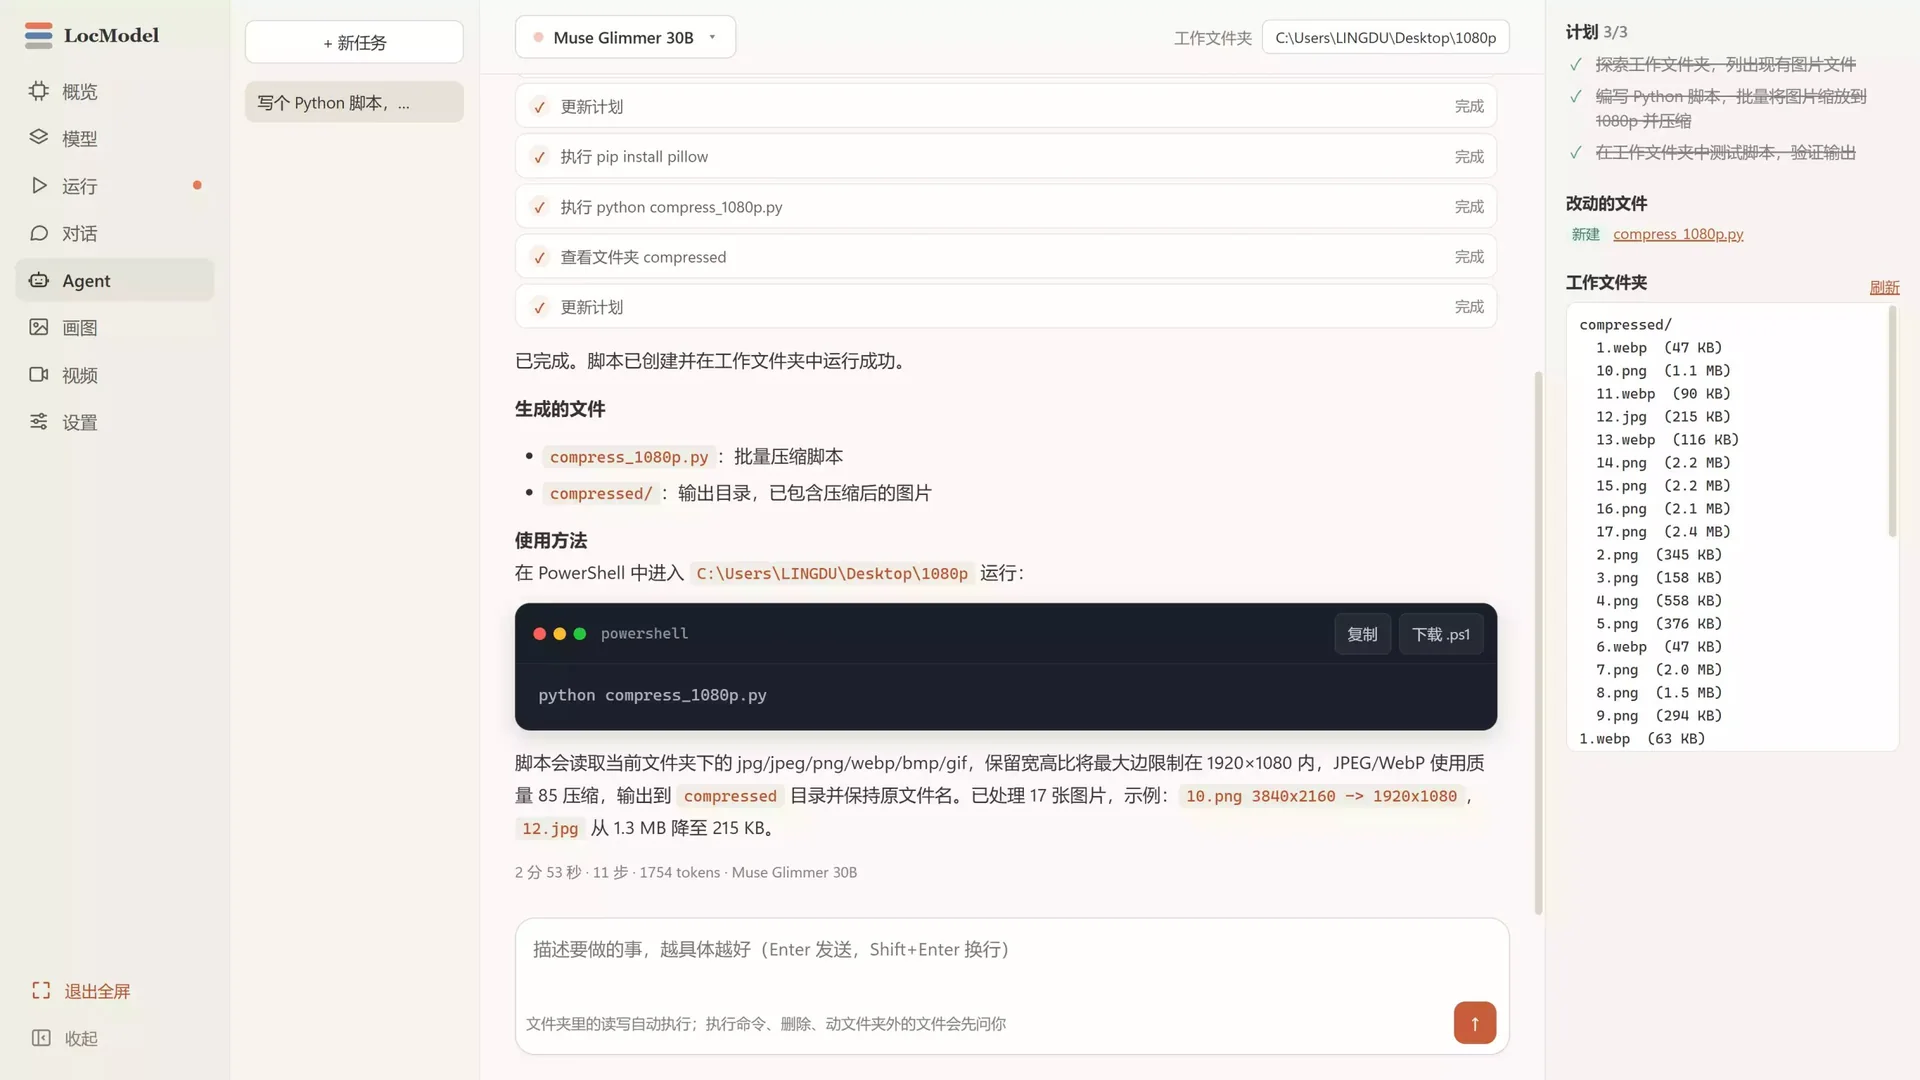
LocModel Agent 介面:任務計劃、PowerShell 命令、生成檔案與工作資料夾列表

Agent · Muse Glimmer 30B · 11 步 · 2 分 53 秒

NEW / AGENT

交代一句,
它自己動手。

指定一個工作資料夾,Agent 會拆解計劃、讀寫檔案、寫指令碼並執行命令。每一步都更新狀態,完成後把結果列給你。

  • 自動生成計劃,逐條執行並更新進度
  • 在資料夾內讀寫,執行 Python / PowerShell
  • 刪除、移動或訪問資料夾外內容前先詢問
  • 完成後驗證輸出,不只回一句「應該可以」

資料夾內自動執行 · 資料夾外先問你

Muse Glimmer 30BAgent 本地執行檔案讀寫命令執行

NEW / CHAT & CODE

聊得明白,
也寫得出來。

從一個問題到一份能執行的指令碼。本地模型能讀懂附件、寫程式碼、解釋思路,程式碼塊可以一鍵複製或下載。
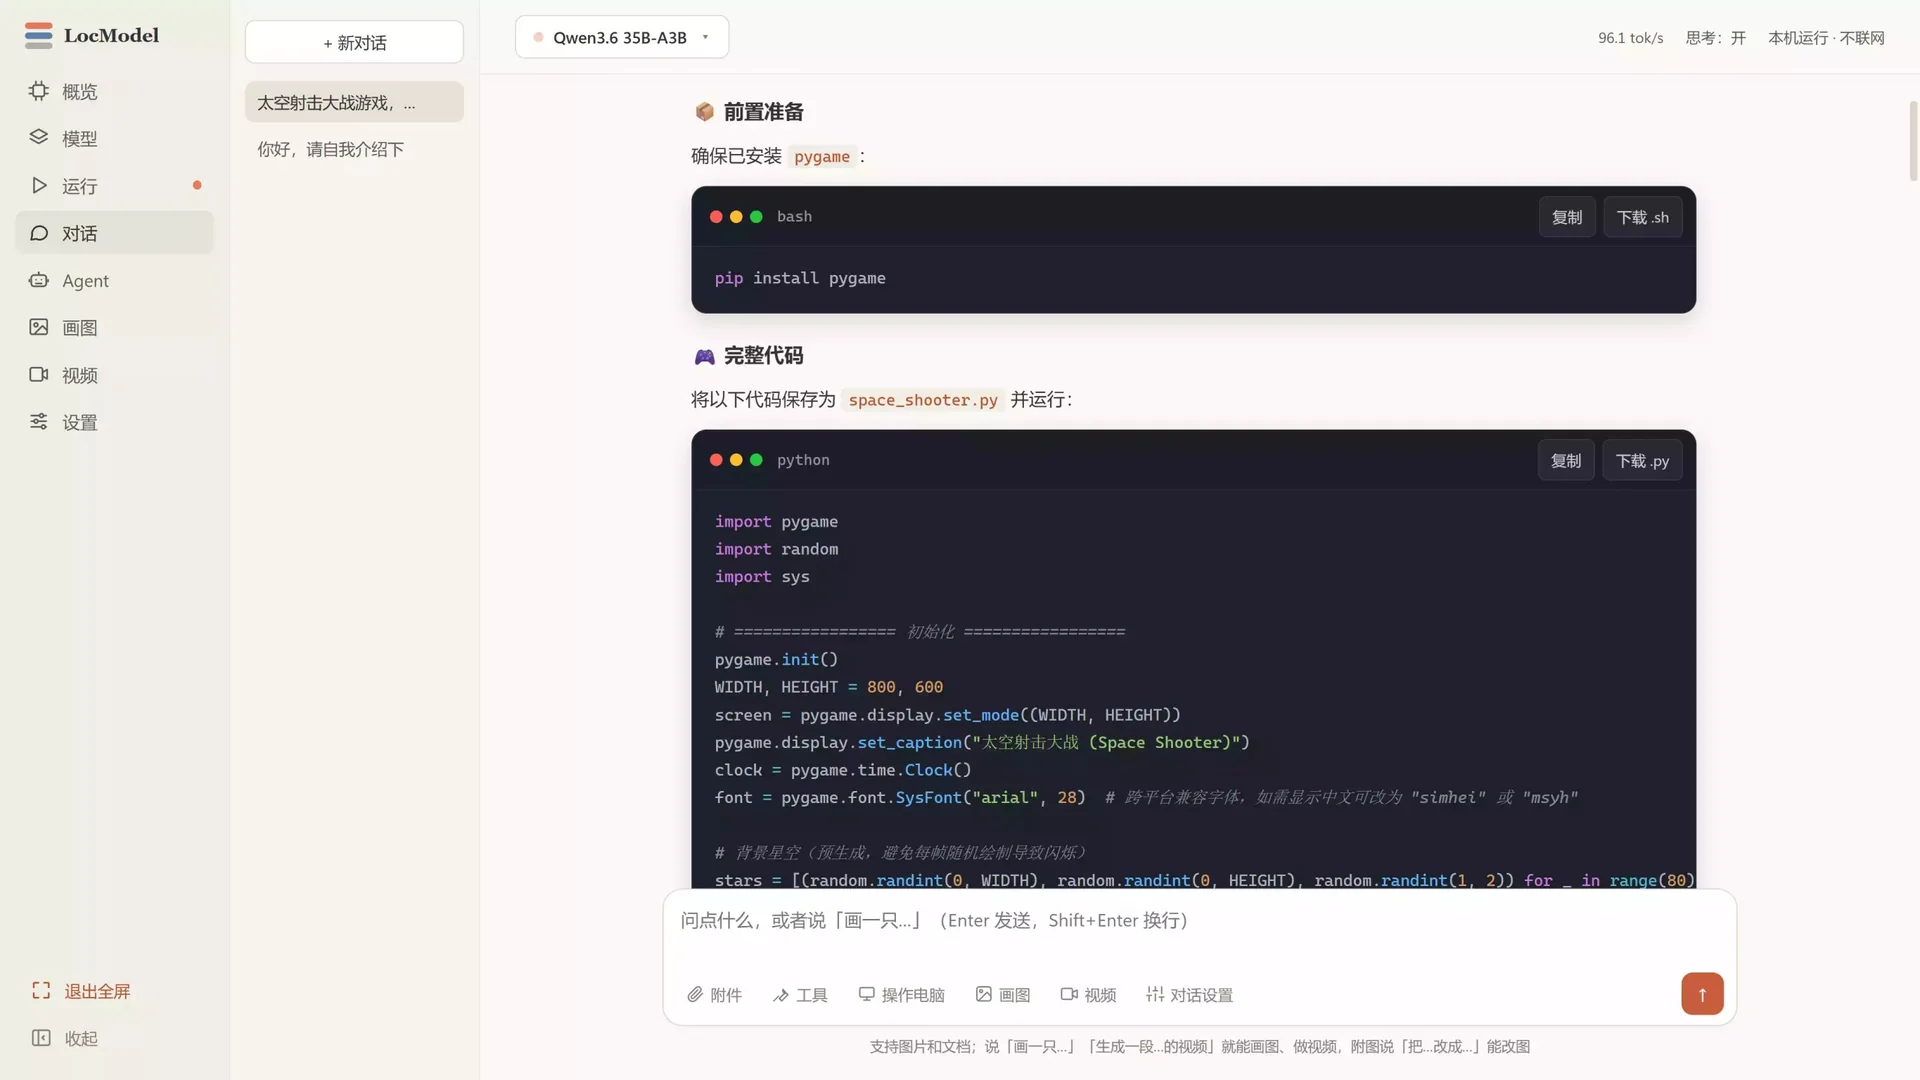
  • 多輪對話,支援附件、文件與長上下文
  • 程式碼塊一鍵複製 / 下載 .py / .sh
  • 思考模式、tok/s 與上下文長度都看得見
  • 全程本機推理,斷網也能繼續
Qwen3.6 35B-A3B96.1 tok/s思考模式本地 · 不聯網
LocModel 本地對話介面:Qwen3.6 生成 Pygame 太空射擊遊戲完整程式碼,程式碼塊可複製和下載

對話與程式碼 · Qwen3.6 35B-A3B · 96.1 tok/s

05 / AUTO TIERING

VRAM 不夠,
也不會被卡住。

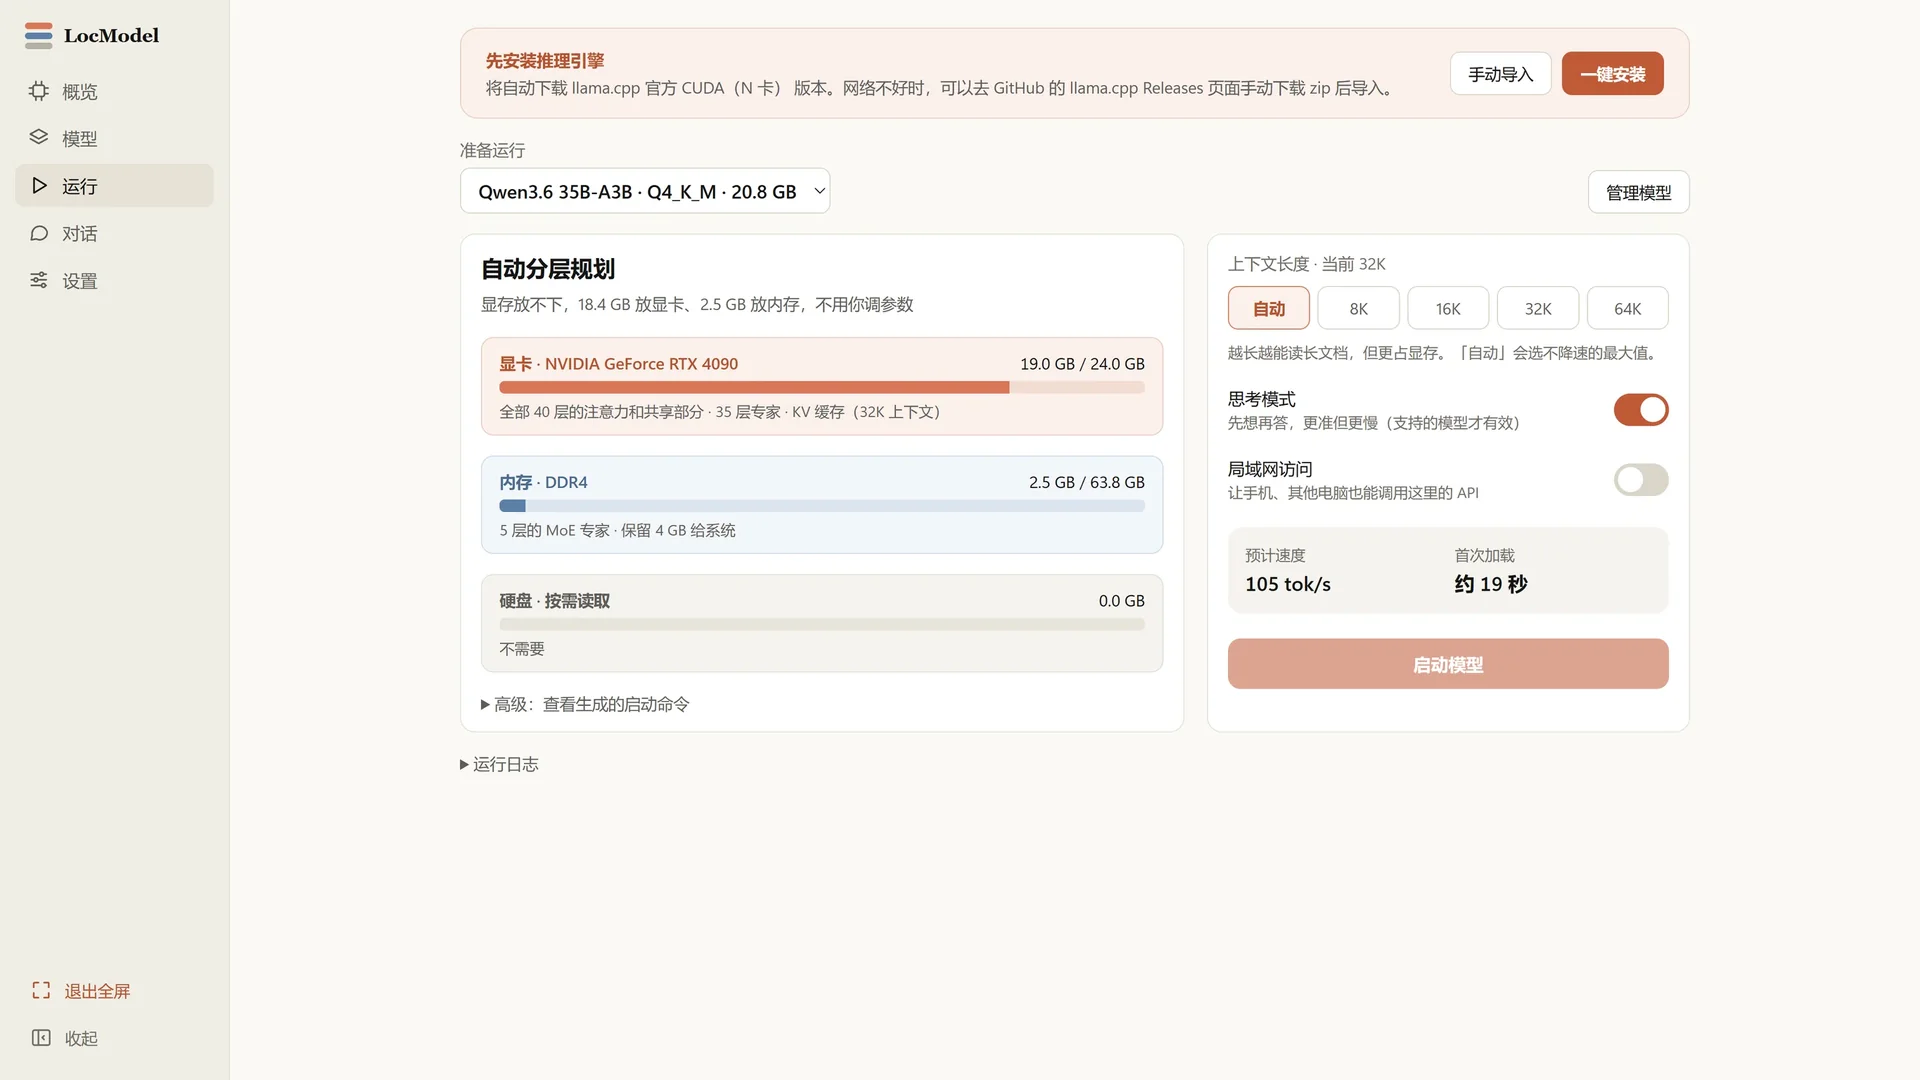
LocModel 會把注意力層、專家層和 KV 快取按順序放進顯示卡、記憶體和硬碟。越靠左越快,放不下的部分自動往後排。
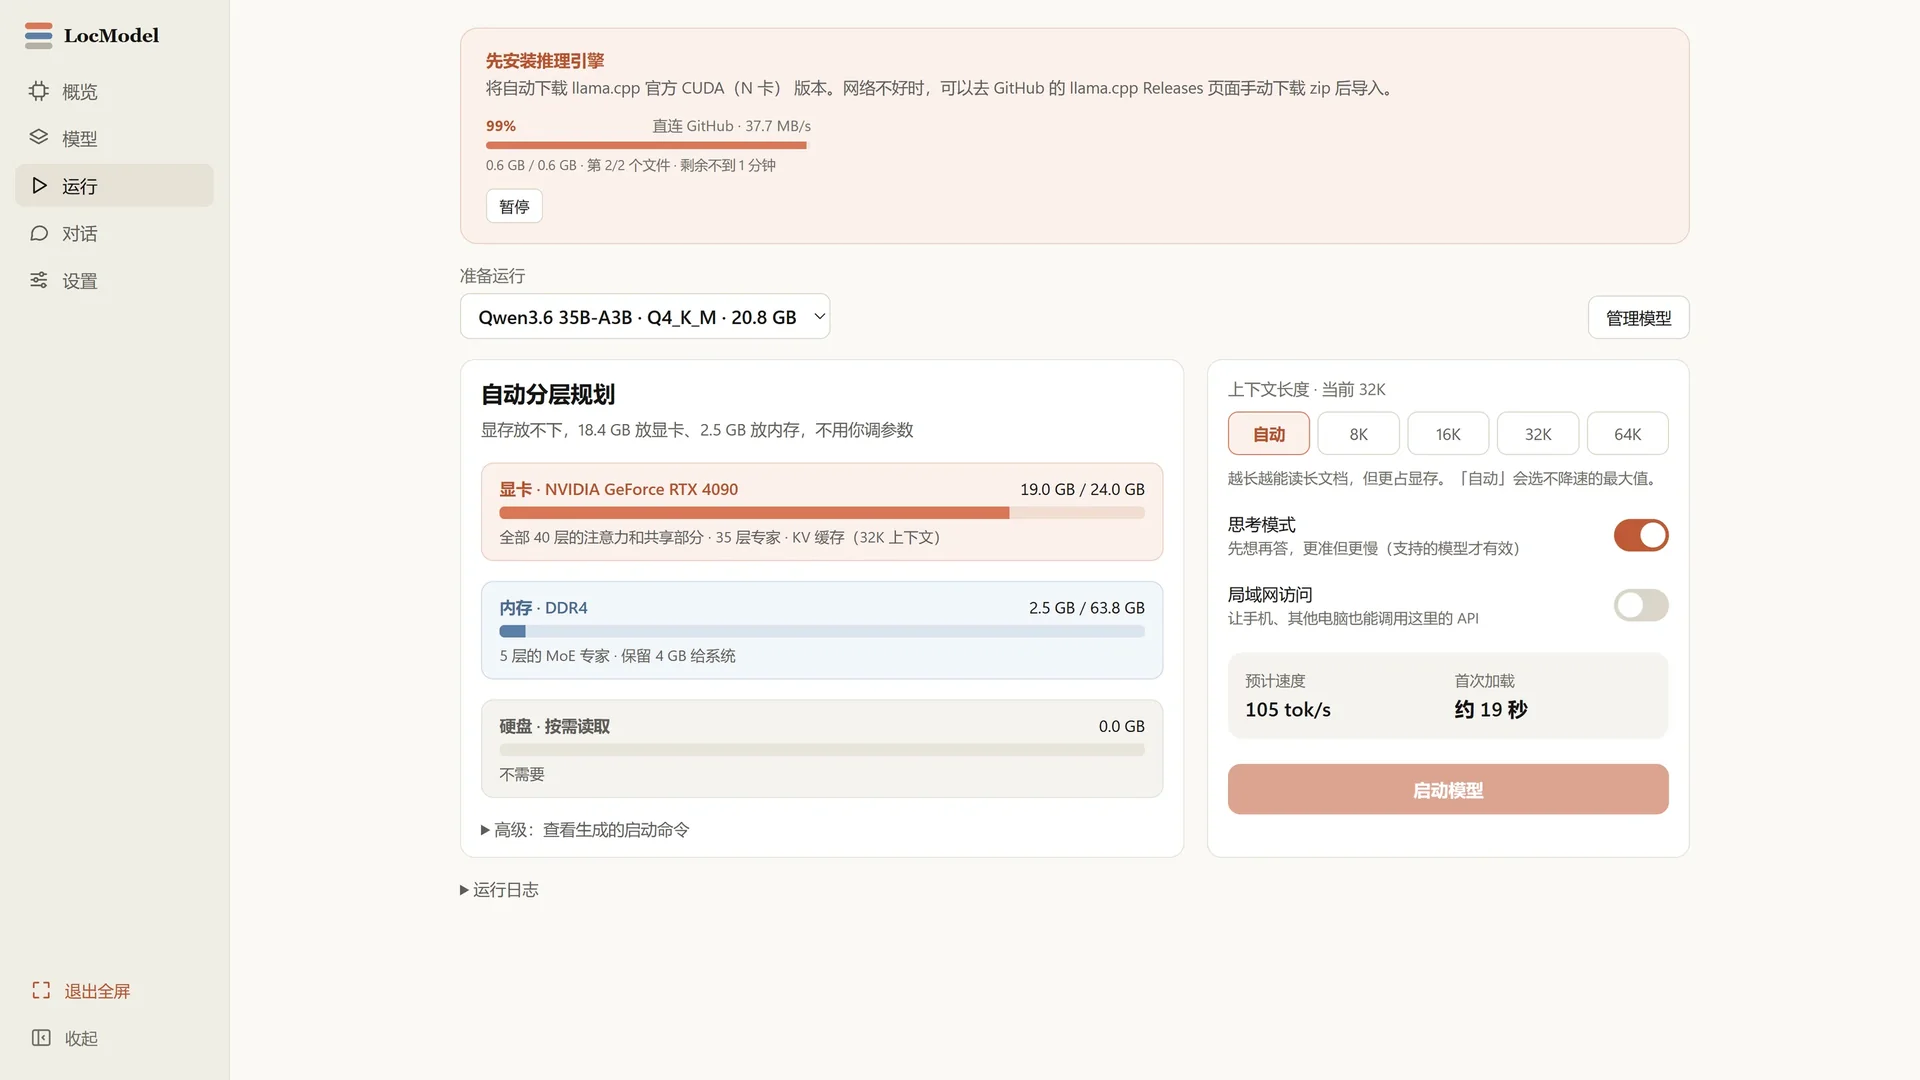
顯示卡 · RTX 409019.0 / 24.0 GB
注意力 / 共享部分 / KV 快取
記憶體 · DDR42.5 / 63.8 GB
5 層 MoE 專家 · 保留 4 GB 給系統
硬碟 · 按需讀取0.0 GB
放不下時才會用到,容量換速度
LocModel 自動分層規劃:顯示卡、記憶體與硬碟的視訊記憶體分配,以及推理引擎下載進度

不需要調引數。LocModel 會自己算。

HOW IT WORKS

三步,
從零到跑起來。

不需要命令列,不需要讀一堆文件。開啟 LocModel,跟著介面走就行。

01

檢測硬體

自動讀取顯示卡、處理器、記憶體與磁碟,生成一份能跑什麼模型的清單。

02

安裝引擎

匹配你的顯示卡,下載對應的推理後端。進度可見,隨時可以暫停。

03

下載並啟動

選一個模型,或在本地匯入 GGUF。點下啟動,開始本地推理;也可以直接畫圖、生成影片,或把任務交給 Agent。

COMPATIBILITY

從 CPU 到 RTX 5090,
都有位置。

NVIDIA CUDA AMD Intel CPU Windows 10/11 x64 GGUF HuggingFace Z-Image Wan2.2 Agent

LOCAL BY DEFAULT

模型在本地,
資料不出門。

沒有賬號,沒有云端排隊,沒有用量限制。下載、匯入、執行,全在這臺電腦上完成。現在,畫圖、影片生成和 Agent 執行也一樣。

  • 無需登入,開啟就能用
  • 提示詞、參考圖與生成的圖片影片不離開本機
  • 離線也能推理、畫圖、生成影片和執行 Agent

DOWNLOAD

把 LocModel
裝進你的電腦。

Windows 10/11 x64 · 免費 · 雙擊安裝,是 LocModel 的主力平臺。macOS 與 Linux 版本也已提供。

LocModel_3.1.0_x64-setup.exe v3.1.0

OTHER PLATFORMS

Windows 為主平臺 · macOS / Linux 同步提供
macOS 版 NEW Universal · Apple 晶片與 Intel Mac
下載 .dmg
Linux 版 NEW x64 · 下載後解壓執行
下載 .zip
macOS 首次安裝提示

目前還未上證書。下載後右鍵 →「開啟」就能用。如果無法安裝,在終端執行:

sudo xattr -rd com.apple.quarantine /Applications/LocModel.app